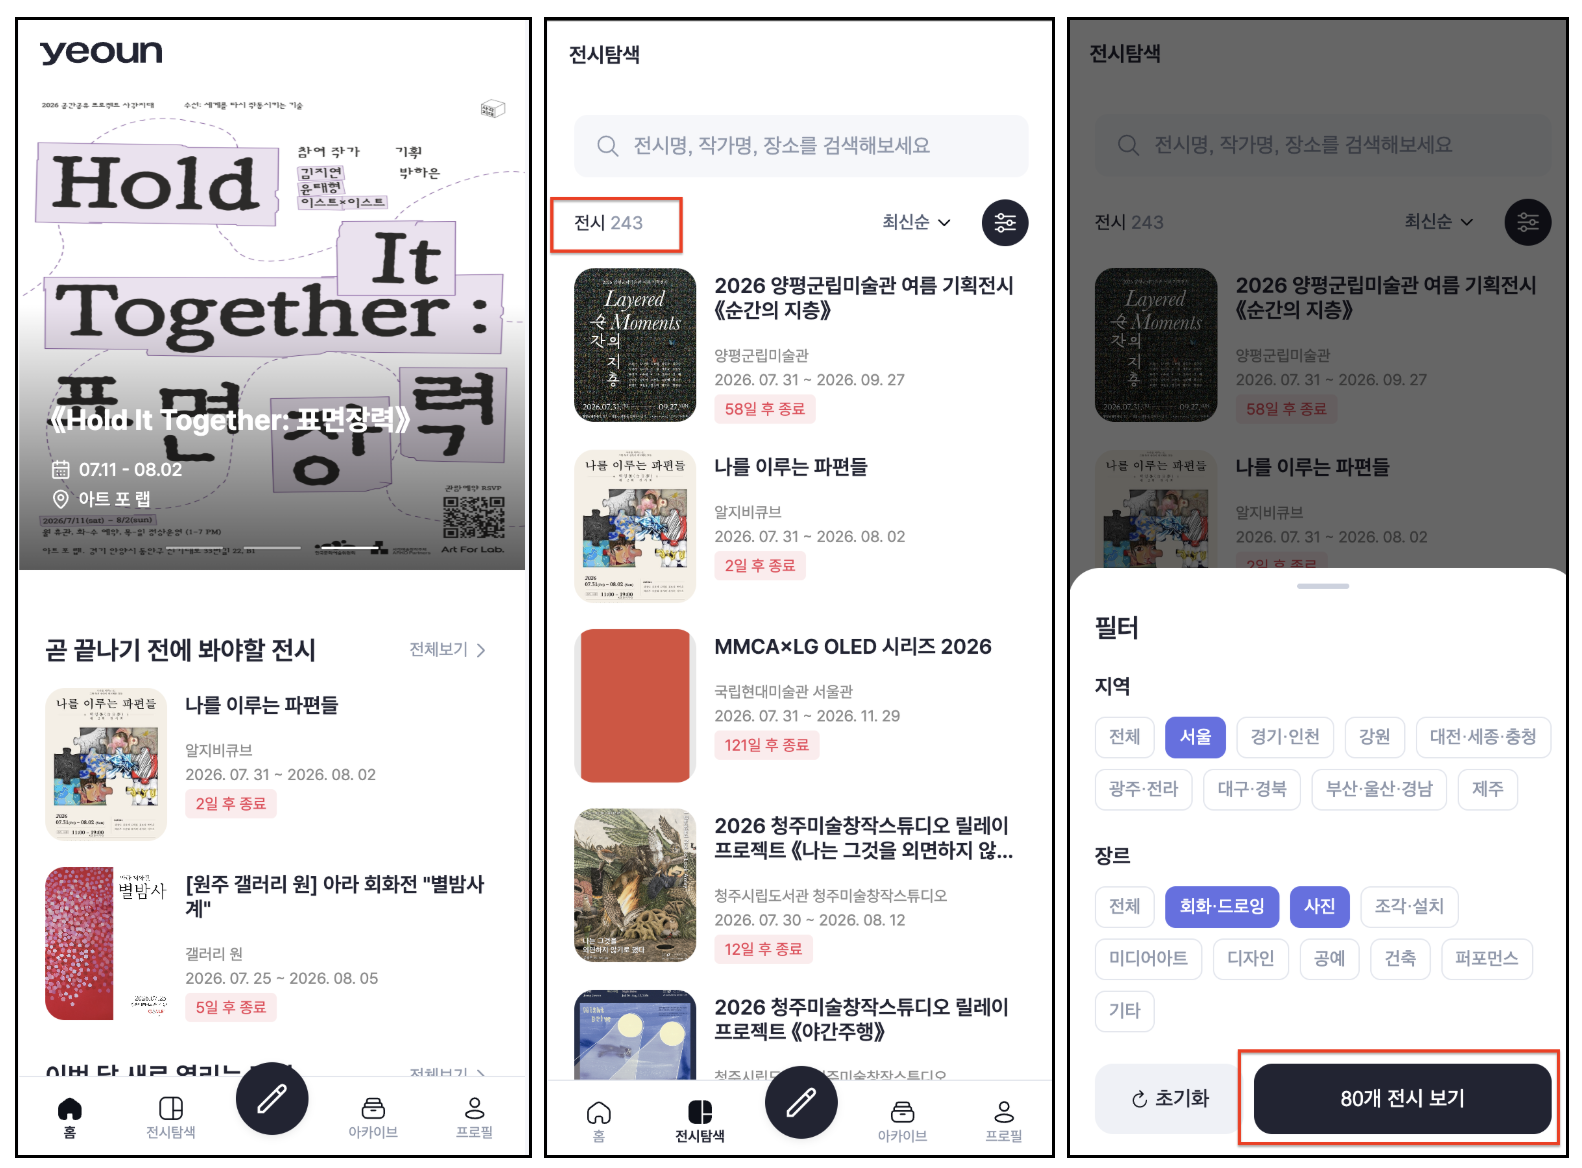
전시 정보 앱의 전시 목록 조회 API를 개발하고 있다. 커서 페이지네이션으로 20건씩 내려주고, 응답에 총 건수(totalCount)를 함께 담는 구조다.
홈 목록 / 전시탐색 목록("전시 243") / 필터 바텀시트("80개 전시 보기")
개발 초기 데이터 313건일 때는 11.6ms였다. 데이터를 늘려가며 부하를 걸어보니 100만 건에서 8,890ms가 나왔다. 화면에 뿌리는 건 여전히 20건인데 9초 가까이 걸린 것이다.
측정 조건
MySQL 8.4 · InnoDB 버퍼풀 128MB(기본값) · 매 측정 전 MySQL 재시작으로 콜드 상태 통일
앱은 호스트 JVM(java -Xmx1g -jar), MySQL만 Docker(2 vCPU)로 분리. 서로 CPU를 다투지 않게 하기 위함
k6 · VU 2 · 경로별 표본 고정 · 시드 고정 아래 숫자는 모두 서버 사이드 응답시간 p50이다.
VU2를 한 이유는 MySQL과 스프링이 2CPU를 공유 하고 있어서 VU3 부터 응답속도가 느려지는 문제가 있어 순수 응답속도를 재기 위해 VU2로 했다.
SQL 하나의 실행 시간이 아니라 요청 1건 = SQL 5개 + HTTP + JVM을 모두 포함한 값이다
전시 행 수
목록 p50
목록 p95
313 건 대비
313 (개발 초기)
11.6 ms
22.3 ms
1×
100,000
589.5 ms
672.1 ms
51×
500,000
4,411.2 ms
4,872.1 ms
380×
1,000,000
8,890.3 ms
9,894.9 ms
766×
행이 3,196배 늘어날 때 지연은 766배 늘었다. 화면에 뿌리는 건 언제나 20건이다. 서버나 네트워크가 느려진 것부터 의심해 보았는데, 같은 관에서 DB를 타지 않는 정적 응답(지역 필터 목록 API)은 0.59 → 2.08ms로 거의 그대로였다. 같은 코드, 같은 서버인데 데이터를 읽는 경로만 함께 무너졌다. 원인은 데이터 조회 쪽에 있다.
쿼리 구조
count 쿼리를 제외한 나머지 쿼리들은 전부 단일테이블을 대상으로하고, 애플리케이션에서 데이터들을 조합하여 API 응답에 실어내는 구조다.
SELECT ... FROM exhibitions WHERE ... ORDER BY ... LIMIT 21
SELECT count(*) FROM exhibitions WHERE ...     ← 2. 응답 totalCount
SELECT ... FROM exhibition_place WHERE id IN (...)
SELECT ... FROM exhibition_detail WHERE exhibition_id IN (...)
2번은 응답에 담을 totalCount라 그럴 수 있다. 문제는 1번이다. Spring Data JPA가 Page를 만들면서 실행한 count인데, 정작 코드는 Page를 받아 getContent()만 꺼내 쓰고 총 건수는 버리고 있었다. 사용처가 없는 쿼리가 매 요청마다 65만 행을 세고 있었던 것이다.
비싼 count 쿼리
목록 조회에서 count 쿼리를 제거하여 쿼리 속도를 비교해봤더니 count를 함께 세던 때 5,382ms -> count를 별도 API로 뺀 뒤 19.7ms 로 측정됐고, 비용의 대부분이 count임을 확인했다.
남은 문제
원인이 count라는 건 알아냈다. 그래서 조건 컬럼에 인덱스를 추가해봤는데 기대만큼 나아지지 않았다. 왜일까.
여기까지가 내 상황이었고, 왜 인덱스를 안타는지? count 쿼리는 무엇을 유념해야하는지? MySQL의 Count의 동작 방식을 알아보자.
01 공식 문서의 COUNT 동작 설명
실험을 시작하기 전에 MySQL 공식 문서부터 찾아 훑어봤는데 COUNT에 대한 설명이 생각보다 자세하게 나와 있다.
성능 문제를 만나면 바로 이것저것 바꿔보고 싶어지는데, 01장에서 그러다 실패했다. 인덱스를 추가했는데 왜 효과가 없는지 설명하지 못했기 때문이다. 그래서 이번엔 문서가 뭐라고 하는지부터 확인하기로 했다.
COUNT(expr) Returns a count of the number of non-NULL values of expr in the rows retrieved by a SELECT statement. COUNT(*) is somewhat different in that it returns a count of the number of rows retrieved, whether or not they contain NULL values.
COUNT(expr)는 SELECT로 조회된 행 중에서 expr이 NULL이 아닌 값의 개수를 반환한다. COUNT(*)는 조금 다른데, NULL 포함 여부와 상관없이 조회된 행의 개수를 반환한다.
눈여겨볼 표현은 “rows retrieved”이다. “테이블의 전체 행”이 아니라 “조회된 행”이라고 되어 있다. WHERE가 붙으면 그 조건에 걸린 행이 대상이라는 뜻이다.
→ 두 함수는 이름만 비슷할 뿐 다르게 동작한다
2. InnoDB는 행 수를 저장해두지 않는다.
InnoDB does not keep an internal count of rows in a table because concurrent transactions might “see” different numbers of rows at the same time. Consequently, SELECT COUNT(*) statements only count rows visible to the current transaction.
동시 트랜잭션이같은 시점에 서로 다른 행 수를 볼 수 있기때문에 InnoDB는 테이블의 행 수를 내부적으로 유지하지 않는다.
따라서SELECT COUNT(*)는현재 트랜잭션에 보이는 행만카운트한다.
한가지 의문 - 왜 Count가 비싼거지 그냥 어디 적어두고 바로 주면 안 되는 걸까?" 에 대한 답이 여기 있었다. 적어둘 수가 없다는 내용이다.
→ 매번 실제로 센다. 캐싱된 값이 아니다
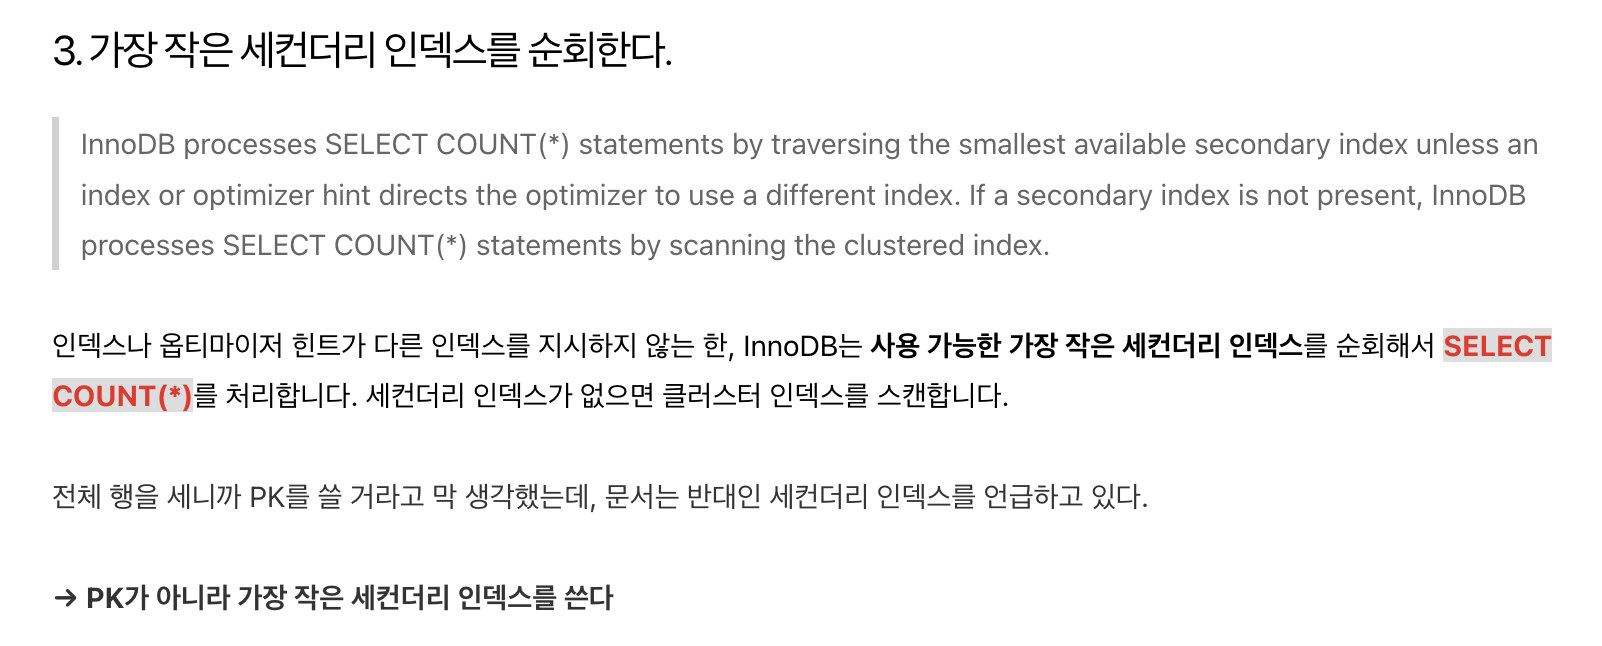
3. 가장 작은 세컨더리 인덱스를 순회한다.
InnoDB processes SELECT COUNT(*) statements by traversing the smallest available secondary index unless an index or optimizer hint directs the optimizer to use a different index. If a secondary index is not present, InnoDB processes SELECT COUNT(*) statements by scanning the clustered index.
인덱스나 옵티마이저 힌트가 다른 인덱스를 지시하지 않는 한, InnoDB는 사용 가능한 가장 작은 세컨더리 인덱스를 순회해서 SELECT COUNT(*)를 처리한다. 세컨더리 인덱스가 없으면 클러스터 인덱스를 스캔한다.
→ PK가 아니라 가장 작은 세컨더리 인덱스를 쓴다
4. 조건이 없을 때만 별도로 최적화된다.
SELECT COUNT(*) FROM tbl_name query performance for InnoDB tables is optimized for single-threaded workloads if there are no extra clauses such as WHERE or GROUP BY.
InnoDB 테이블에 대한 SELECT COUNT(*) FROM tbl_name의 성능은 WHERE나 GROUP BY 같은 추가 절이 없는 경우에 한해 단일 스레드 워크로드에 최적화되어 있다.
"if there are no extra clauses"라는 조건이 붙어 있다. 내 API의 count 쿼리에는 필터가 붙어 있으니 이 최적화 대상이 아니었던 셈이다.
네 문장을 이어 붙이면 COUNT의 큰 그림이 나온다. InnoDB는 행 수를 저장해두지 않으므로 매번 실제로 세고(②), 셀 때는 가장 작은 세컨더리 인덱스를 순회하며(③), 조건이 없을 때만 별도 최적화 경로를 탄다(④). 그리고 무엇을 세느냐는 COUNT(*) vs COUNT(expr)에 따라 달라진다(①)
✅ 여기까지가 문서가 알려주는 내용이다. 01장에서 "인덱스를 추가해도 나아지지 않았던" 이유도 ④에 힌트가 있어 보인다. 내 쿼리에는 WHERE가 붙어 있었기 때문이다.
반면 늘어난 의문
문장은 이해했는데, 정작 내 코드를 어떻게 고쳐야 하는지는 여전히 알 수 없었다. 문서는 "무엇이 일어나는지"를 알려주지만 "왜 그런지"와 "얼마나 차이 나는지"는 말해주지 않는다. 읽고 나서 오히려 의문이 늘었다.
문서
남은 의문
2 에 대해
"동시 트랜잭션이 다른 행 수를 본다"는 게 실제로 어떤 상황인가. 문장은 읽히는데 그림이 안 그려져서 정말 그런지 눈으로 봐야 납득이 될 것 같다.
3 에 대해
"가장 작은"의 기준이 무엇인가. 그리고 왜 작으면 빠른가. 문서는 "smallest"라고만 한다. 무엇을 기준으로 작은지, 왜 그게 유리한지는 설명하지 않는다.
4 에 대해
WHERE가 붙으면 얼마나 느려지는가. 인덱스로 만회할 수는 없는가. 01장에서 실제로 막혔던 지점이다. "최적화되지 않는다"와 "인덱스가 소용없다"는 다른 얘기다.
1 에 대해
COUNT(expr)로 작은 컬럼을 직접 지정하면 더 빨라지지 않는가. 3이 “작은 인덱스가 유리하다”고 했으니 떠오른 생각이다.
💡 그래서 실험을 진행했다. 문서의 문장을 눈으로 확인하고, 문서가 말하지 않은 "왜"와 "얼마나"를 직접 재보기로 했다. 결과적으로 문서에 아예 없는 사실도 하나 발견하게 되는데, 그건 08장에서 다룬다.
02 실험 환경 설계하기
서비스 코드를 그대로 두고 실험하면 변수가 너무 많다. COUNT만 격리해서 볼 수 있는 테이블을 따로 만들었다.
원인을 제대로 알려면 변수를 하나씩 통제하면서 관찰해야 한다. 그런데 실제 서비스 테이블은 컬럼도 인덱스도 이미 정해져 있고, 인덱스를 마음대로 붙였다 뗐다 하기도 어렵다. 그래서 학습 전용 테이블을 따로 만들었다. 이 테이블은 어떤 기능도 담당하지 않고, 오직 COUNT의 동작을 관찰하기 위해 존재한다.
테이블을 이렇게 설계한 이유
컬럼 구성은 02장에서 읽은 문서 문장에서 거꾸로 뽑아냈다. 문서 ③이 "가장 작은 세컨더리 인덱스"라고 했으니 크기가 다른 타입이 여러 개 있어야 무엇을 기준으로 고르는지 볼 수 있고, 문서 ①이 COUNT(expr)는 "NULL이 아닌 값"을 센다고 했으니 NULL을 허용하는 컬럼과 그렇지 않은 컬럼이 함께 있어야 비교가 된다.
다만 어느 것이 실제로 영향을 줄지는 알 수 없다. 문서는 "작은 인덱스"라고만 하지 크기의 기준이 무엇인지 말해주지 않기 때문이다. 그래서 "영향이 있을 법한 요소를 모두 넣어두고, 영향이 없으면 없다는 것을 확인한다"는 방침으로 잡았다. 예상 밖의 결과가 나왔을 때 비교 대상이 같은 테이블 안에 있어야 원인을 좁힐 수 있다.
실험 대상이 실제 기능이 아니라서 가능한 설계이기도 하다. 서비스 테이블이었다면 컬럼을 이렇게 자유롭게 넣지도, 인덱스를 반복해서 붙였다 뗐다 하지도 못했을 것이다.
CREATE TABLE `post_entity` (
  `id`            bigint       NOT NULL AUTO_INCREMENT,  -- PK (8B)
  `first_title`   varchar(10)  NOT NULL,      -- 문자열 + NOT NULL
  `second_title`  varchar(10)  DEFAULT NULL,  -- 문자열 + nullable  ← 비교군
  `content`       varchar(100) DEFAULT NULL,  -- 더 긴 문자열
  `genre`         enum('DAILY','ETC','INFO') NOT NULL,  -- 가장 작은 타입 (1B)
  `create_date`   date         NOT NULL,      -- 날짜 (3B)
  `updated_date`  date         DEFAULT NULL,
  PRIMARY KEY (`id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
넣어둔 것
관찰하려는 것
bigint / varchar / enum / date 크기가 제각각인 타입 4종
문서 3의 "가장 작은 인덱스"가 무엇을 기준으로 하는지 보려고 서로 다른 크기를 골고루 깔아뒀다. 타입이 영향을 주지 않는다면 실행 계획이 변하지 않을 테고, 그것도 하나의 답이다.
NOT NULL 3개 / nullable 3개
문서 1이 COUNT(expr)를 "NULL이 아닌 값의 개수"로 정의했으니, 한 테이블 안에 둘 다 있어야 같은 조건에서 비교할 수 있다.
인덱스는 PK만
실험 도중에 하나씩 추가하며 관찰하려고 비워뒀다. 처음부터 걸어두면 무엇이 무엇을 바꿨는지 알 수 없다.
실제 데이터 대신 규칙적인 더미
값의 분포를 정확히 알고 있어야, 결과가 이상할 때 데이터를 의심하지 않고 원인에 집중할 수 있다.
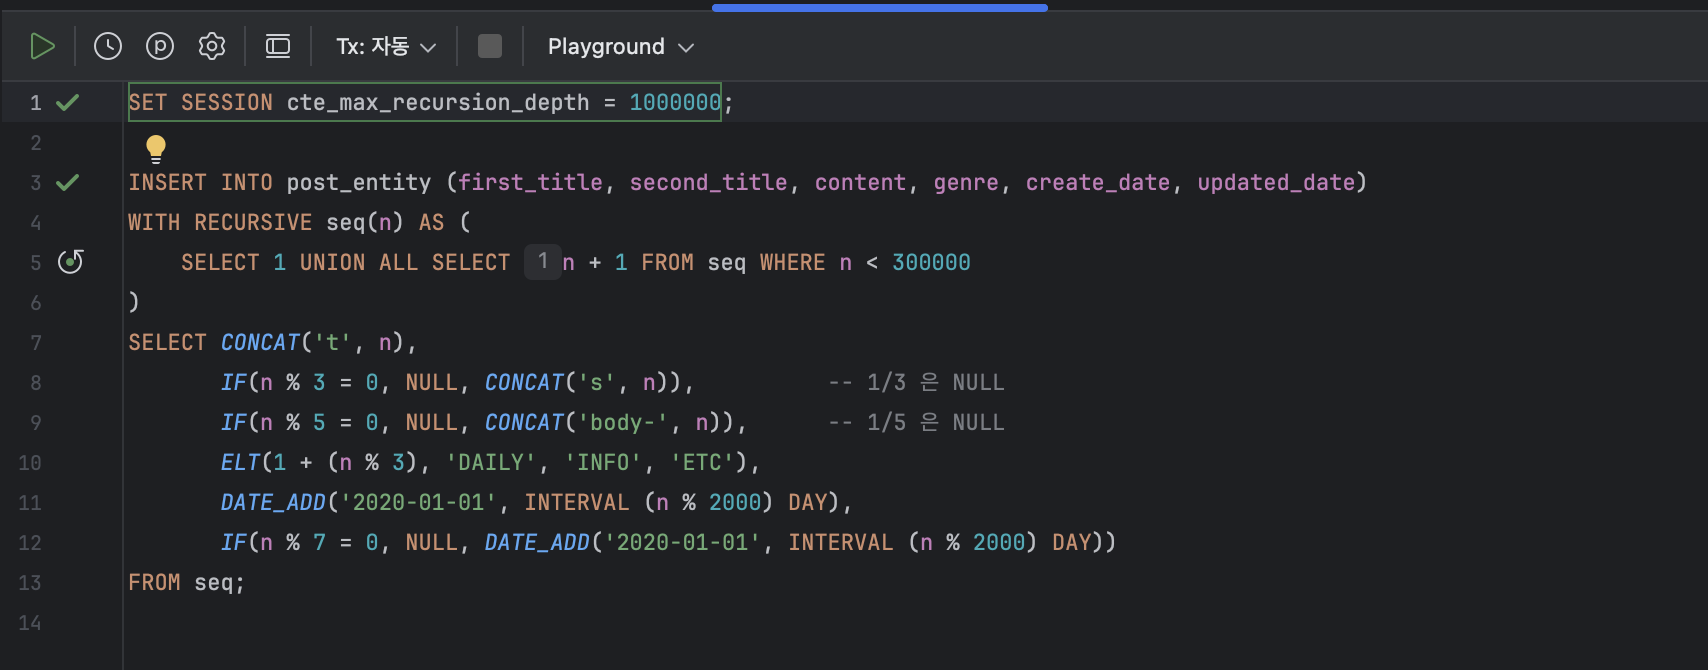
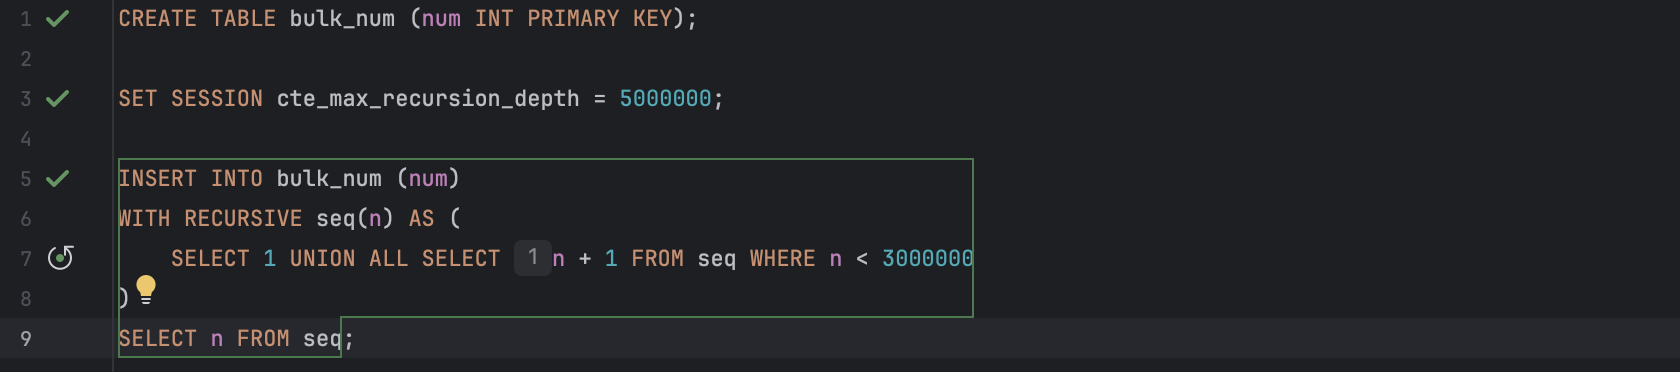
데이터는 재귀 CTE로 300,000건을 생성했다. 여기서 한 가지 더 신경 쓴 부분이 있는데,second_title은 1/3, content는 1/5을 의도적으로 NULL로 채웠다.
이는 2장에서 읽은 문서 1의 내용 때문이다. 문서에 따르면COUNT(*)는 조회된 행을 모두 세지만,COUNT(expr)는 NULL이 아닌 값만 센다. 그렇다면 NULL이 섞여 있어야 애초에 두 함수를 비교할 수 있다. 모든 값이 차 있으면 두 결과가 똑같이 나와서 아무것도 관찰할 수 없다.
이 시점에는 둘의 성능이 다른지까지는 알 수 없었다. 문서에도 그런 말은 없다. 그래도 비교할 수 있는 상태로 만들어두는 건 공짜라 미리 비워뒀는데, 이 선택이 실제로 뒤에서 쓰이게 된다(08장).
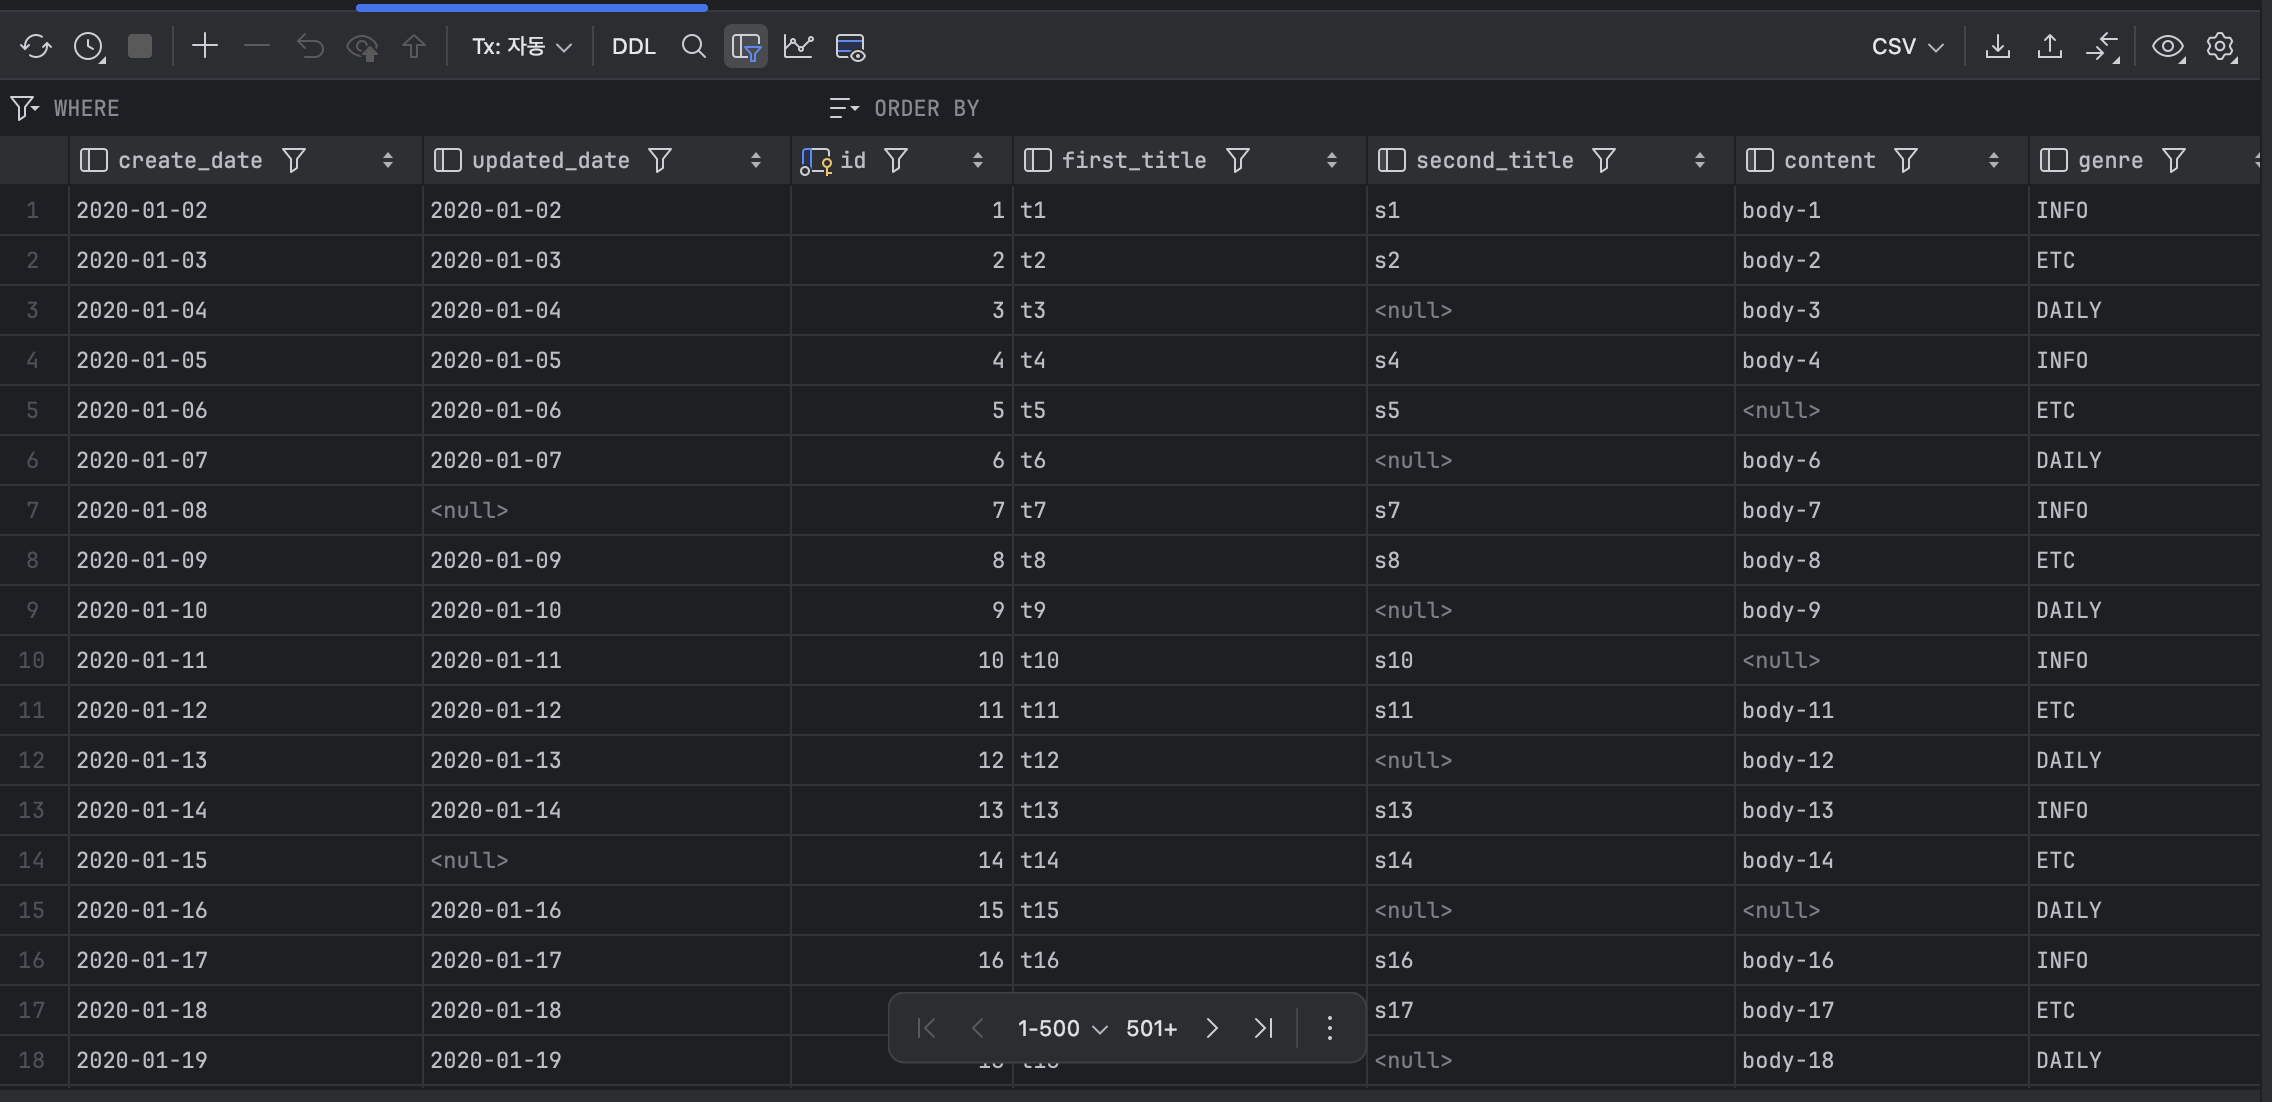
데이터 생성생성 결과
확인할 항목
02장에서 문서를 읽고 남은 의문을 실험으로 확인할 수 있는 형태로 옮겼다. 각 항목이 어느 문서 문장에서 나왔는지도 함께 적어둔다.
Q1 · 문서 2
"동시 트랜잭션이 다른 행 수를 본다"를 눈으로 확인하기 세션을 두 개 띄우고 한쪽 트랜잭션을 열어둔 채 다른 쪽에서 INSERT를 실행하면 된다.
Q2 · 문서 3
"가장 작은 인덱스"의 기준이 무엇인지 알아내기 인덱스를 하나씩 추가하며 실행 계획이 어떻게 바뀌는지 보면 기준이 드러날 것이다.
Q3 · 문서 4
WHERE가 붙으면 얼마나 느려지는지 재기 01장에서 막혔던 지점이다. 같은 행 수를 세면서 조건 유무만 바꿔 비교하면 된다.
💡 미리 밝혀두면, 이 세 개로 끝나지 않았다. Q2를 확인하다가 숫자가 앞뒤가 맞지 않는 결과를 만나 항목이 하나 늘었고(06장), 문서 1에서 파생된 아이디어를 검토하다가 문서에 없는 사실을 발견해서 또 하나 늘었다(08장). 순서대로 정리해두긴 했지만, 실제로는 이렇게 깔끔하게 진행되지 않았다.
✅ 측정 규칙, 모든 쿼리는 3회 실행하여 2·3회차 값을 사용했다. InnoDB 버퍼 풀이 비어 있는 상태에서는 첫 실행이 몇 배 더 느리게 나오기 때문이다.
03 InnoDB가 행 수를 저장하지 않는 이유
Q1 · 문서 2 - “동시 트랜잭션이 같은 시점에 다른 행 수를 본다”는 게 실제로 어떤 상황인가.
문서 2는 InnoDB가 행 수를 저장해두지 않는 이유를 "동시 트랜잭션이 같은 시점에 서로 다른 행 수를 볼 수 있기 때문"이라고 설명했다. 문장은 읽히는데 그림이 잘 안 그려졌다. 같은 테이블의 행 수가 동시에 두 개일 수 있다는 뜻인가.
참고로 모든 엔진이 이런 것은 아니다. MyISAM은 메타데이터에 전체 행 수를 유지하고 있어서 SELECT COUNT(*)를 별도 연산 없이 즉시 반환한다. 즉 못 하는 게 아니라 InnoDB가 하지 않는 것이고, 문서는 그 이유를 트랜잭션에서 찾고 있다.
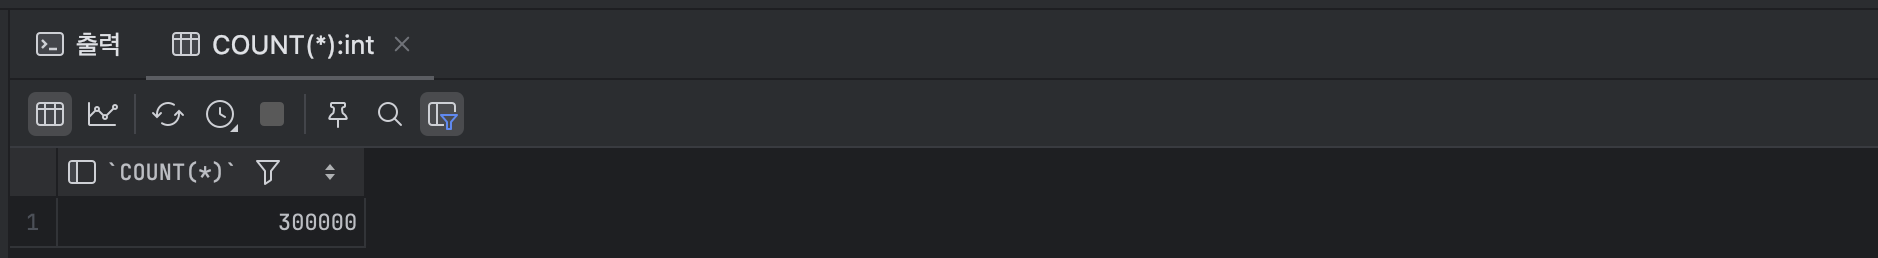
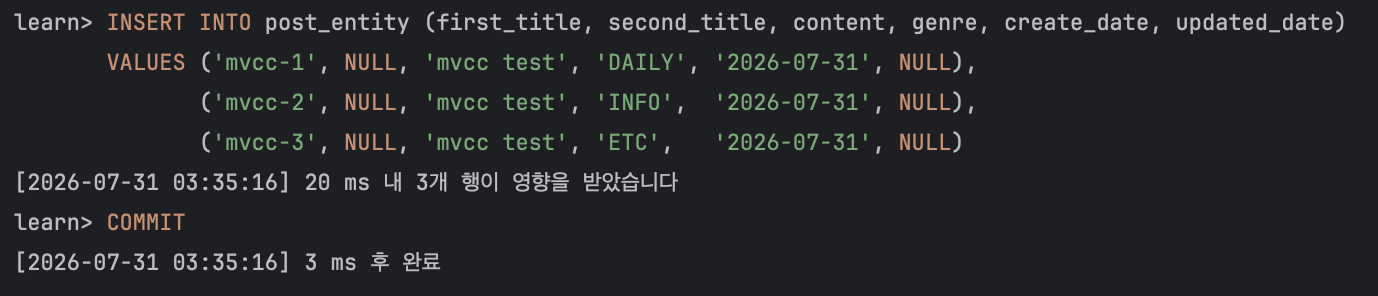
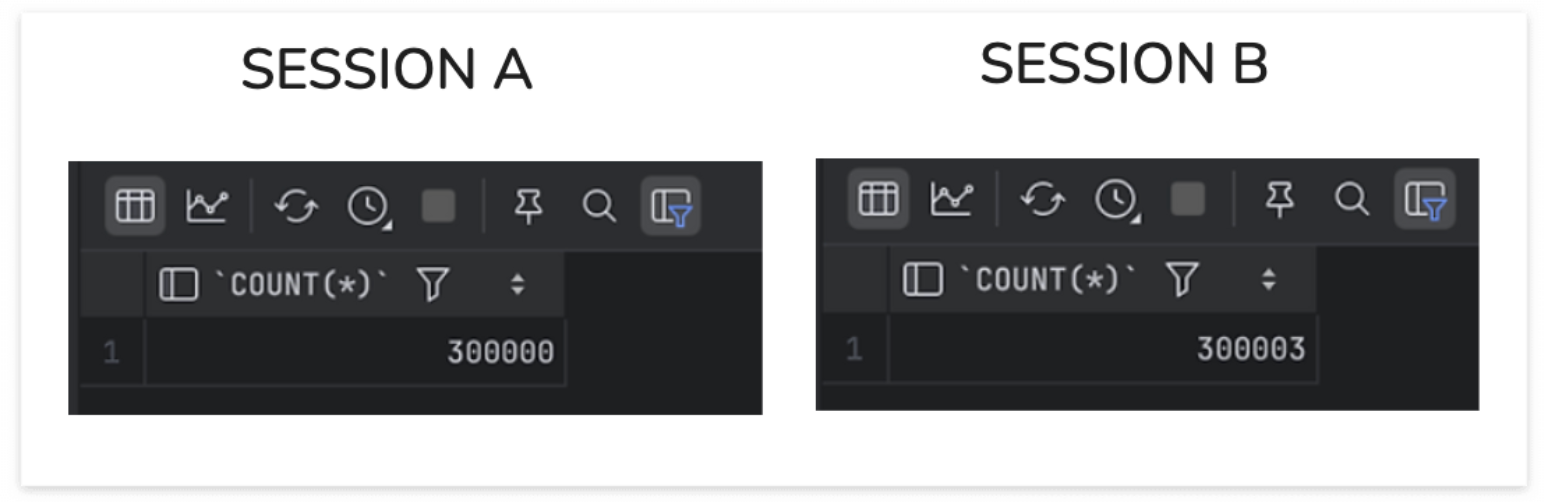
글로만 보고 넘어가면 남는 게 없을 것 같아 직접 상황을 만들었다. 세션 두 개를 띄우고, 한쪽 트랜잭션을 열어둔 채 다른 쪽에서 INSERT를 실행했다.
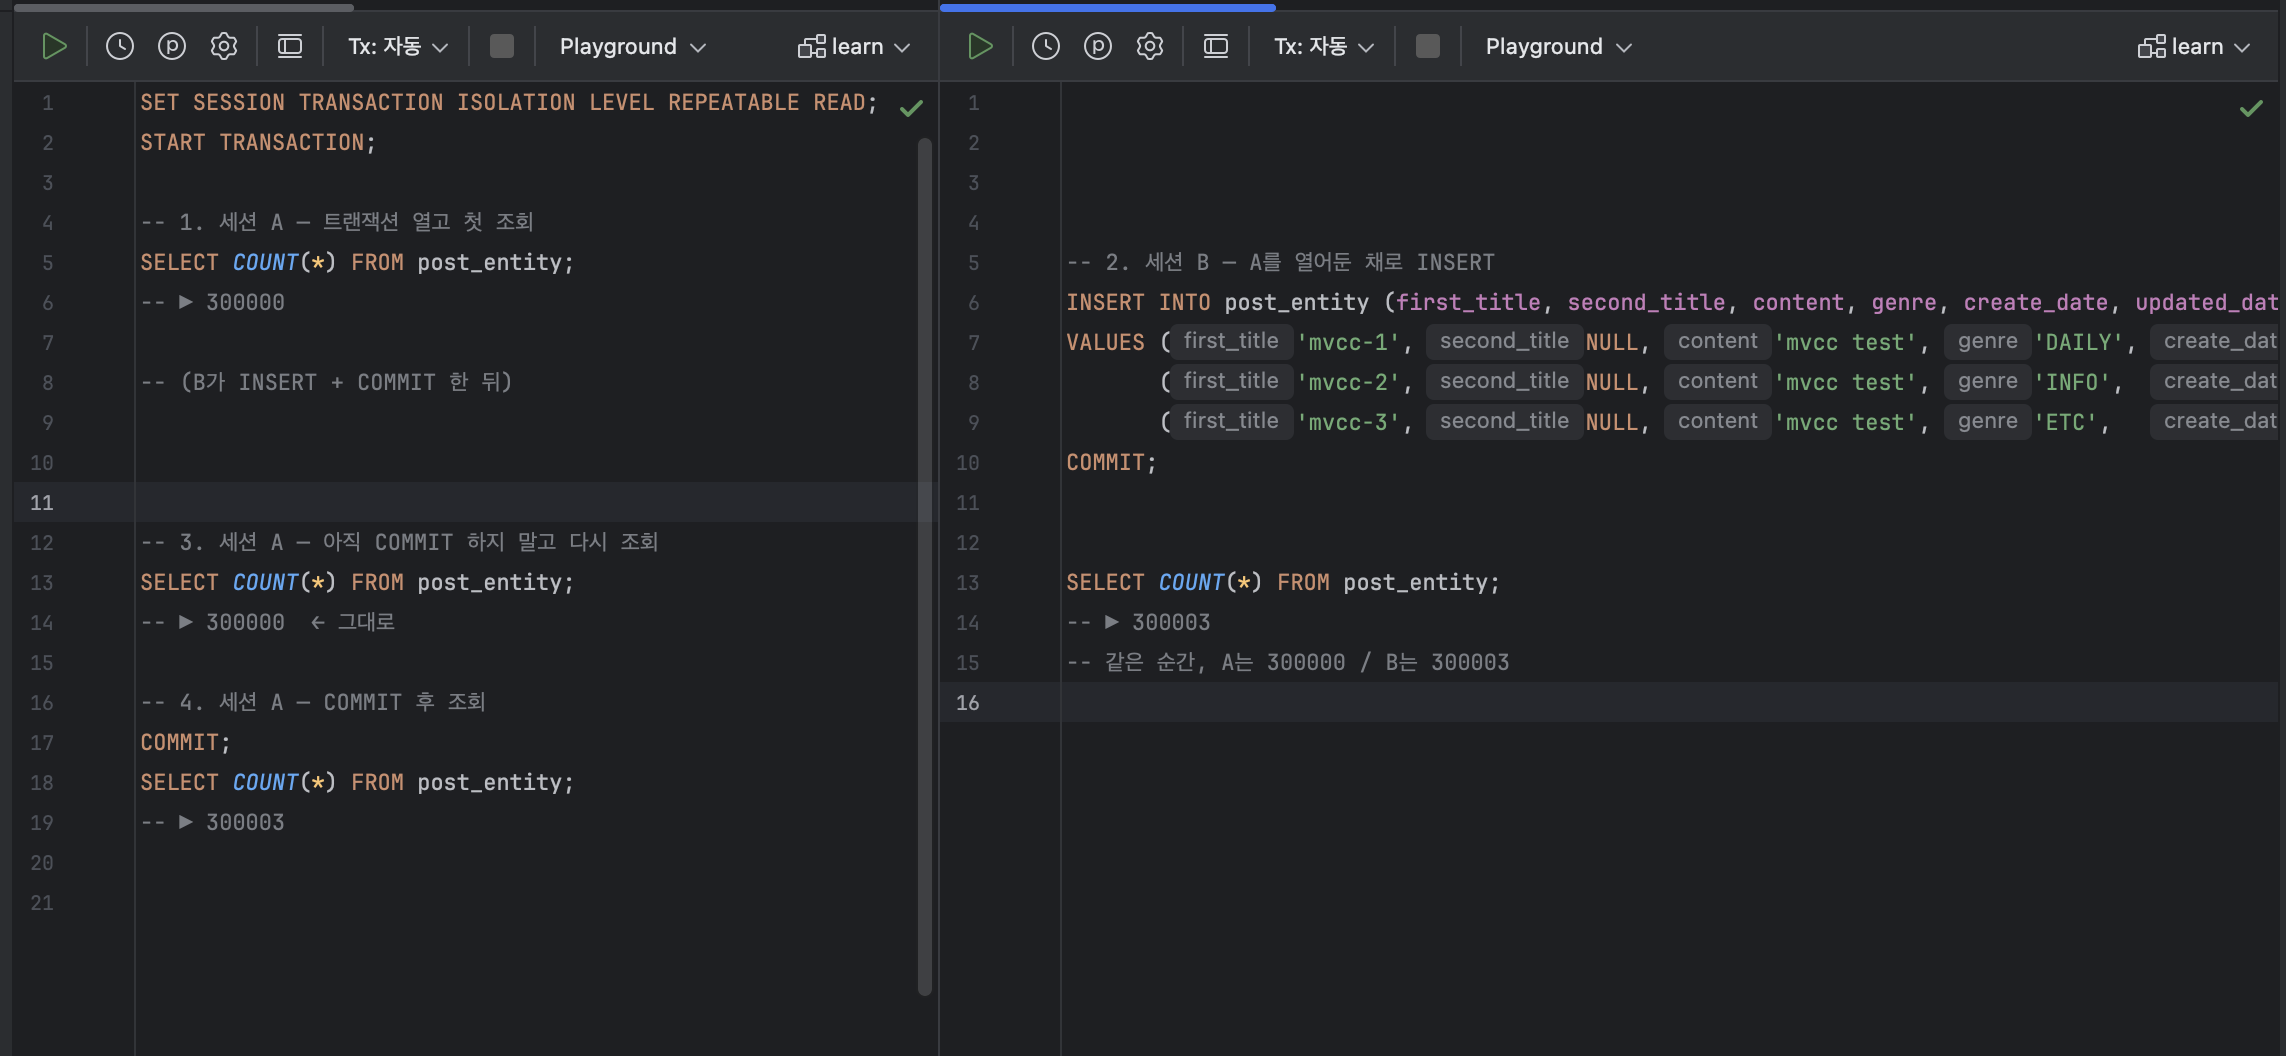
SESSION A (왼쪽) / SESSION B (오른쪽)
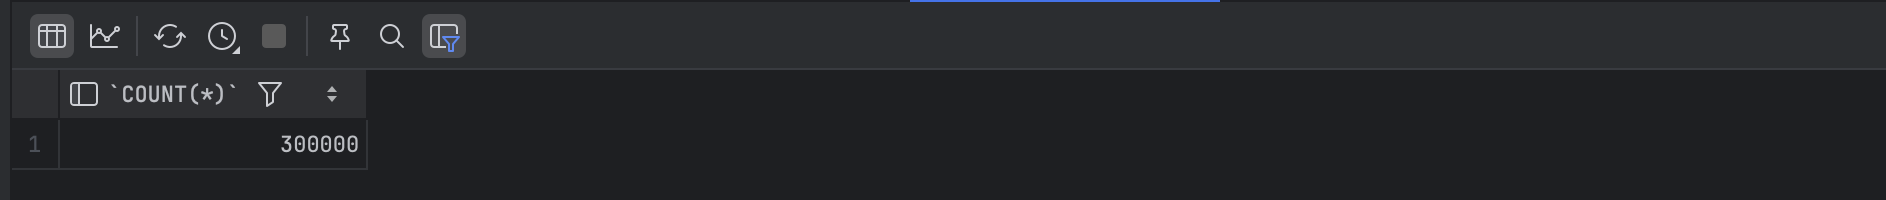
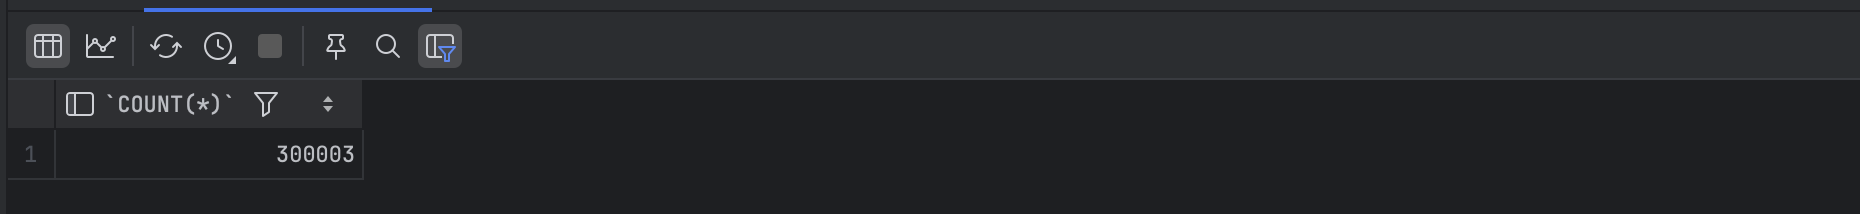
같은 순간, 같은 테이블의 행 수가 두 개다. A는 300,000을 보고 B는 300,003을 보는데, 둘 다 틀린 값이 아니다. 트랜잭션마다 자신의 스냅샷 기준으로 보이는 행이 다르기 때문이다(MVCC)
SESSION A
1. 트랜잭션 열고 첫 조회
SESSION B
2. A를 열어둔 채로 INSERT
SESSION A
3.1 아직 COMMIT 하지 말고 다시 조회
SESSION B
3.2 같은 순간 A는 300000 / B는 300003
SESSION A
4. COMMIT 후 조회
✅ Q1(동시 트랜잭션이 같은 시점에 다른 행 수를 본다는게 무슨 상황?) 확인 완료
InnoDB가 행 수를 하나로 유지하는 것은 애초에 불가능하다. "어느 트랜잭션 기준으로 세어둘 것인가"에 답이 없기 때문이다. 그래서 COUNT는 매번 현재 트랜잭션에 보이는 행을 실제로 센다. MyISAM이 즉답할 수 있는 것은 트랜잭션이 없기 때문이다.
정리하면 COUNT를 공짜로 만들 방법은 없다는 게 확인됐다. 그렇다면 남은 것은 "얼마나 싸게 세느냐"다.
05 COUNT(*) 실행 계획과 옵티마이저의 인덱스 선택
Q2 · 문서 3 - "가장 작은 세컨더리 인덱스"라는데, 무엇을 기준으로 작다는 걸까?
Q1에서 "매번 실제로 센다"가 확인됐으니, 다음은 무엇을 읽어서 세느냐다. 문서 3은 "가장 작은 세컨더리 인덱스를 순회한다"고 했는데, 처음 읽었을 때는 잘 믿기지 않았다. 전체 행을 세는 거니까 행마다 하나씩 있는 PK를 훑는 게 자연스러워 보였기 때문이다.
그리고 문서는 "작다"의 기준을 알려주지 않는다. 컬럼 개수인지, 바이트 크기인지, 아니면 다른 무엇인지 알 수 없다. 그래서 인덱스를 하나씩 추가하면서 실행 계획이 어떻게 바뀌는지 관찰하기로 했다. 옵티마이저가 갈아타는 순서를 보면 기준이 드러날 것이라고 판단했다.
인덱스가 없을 때
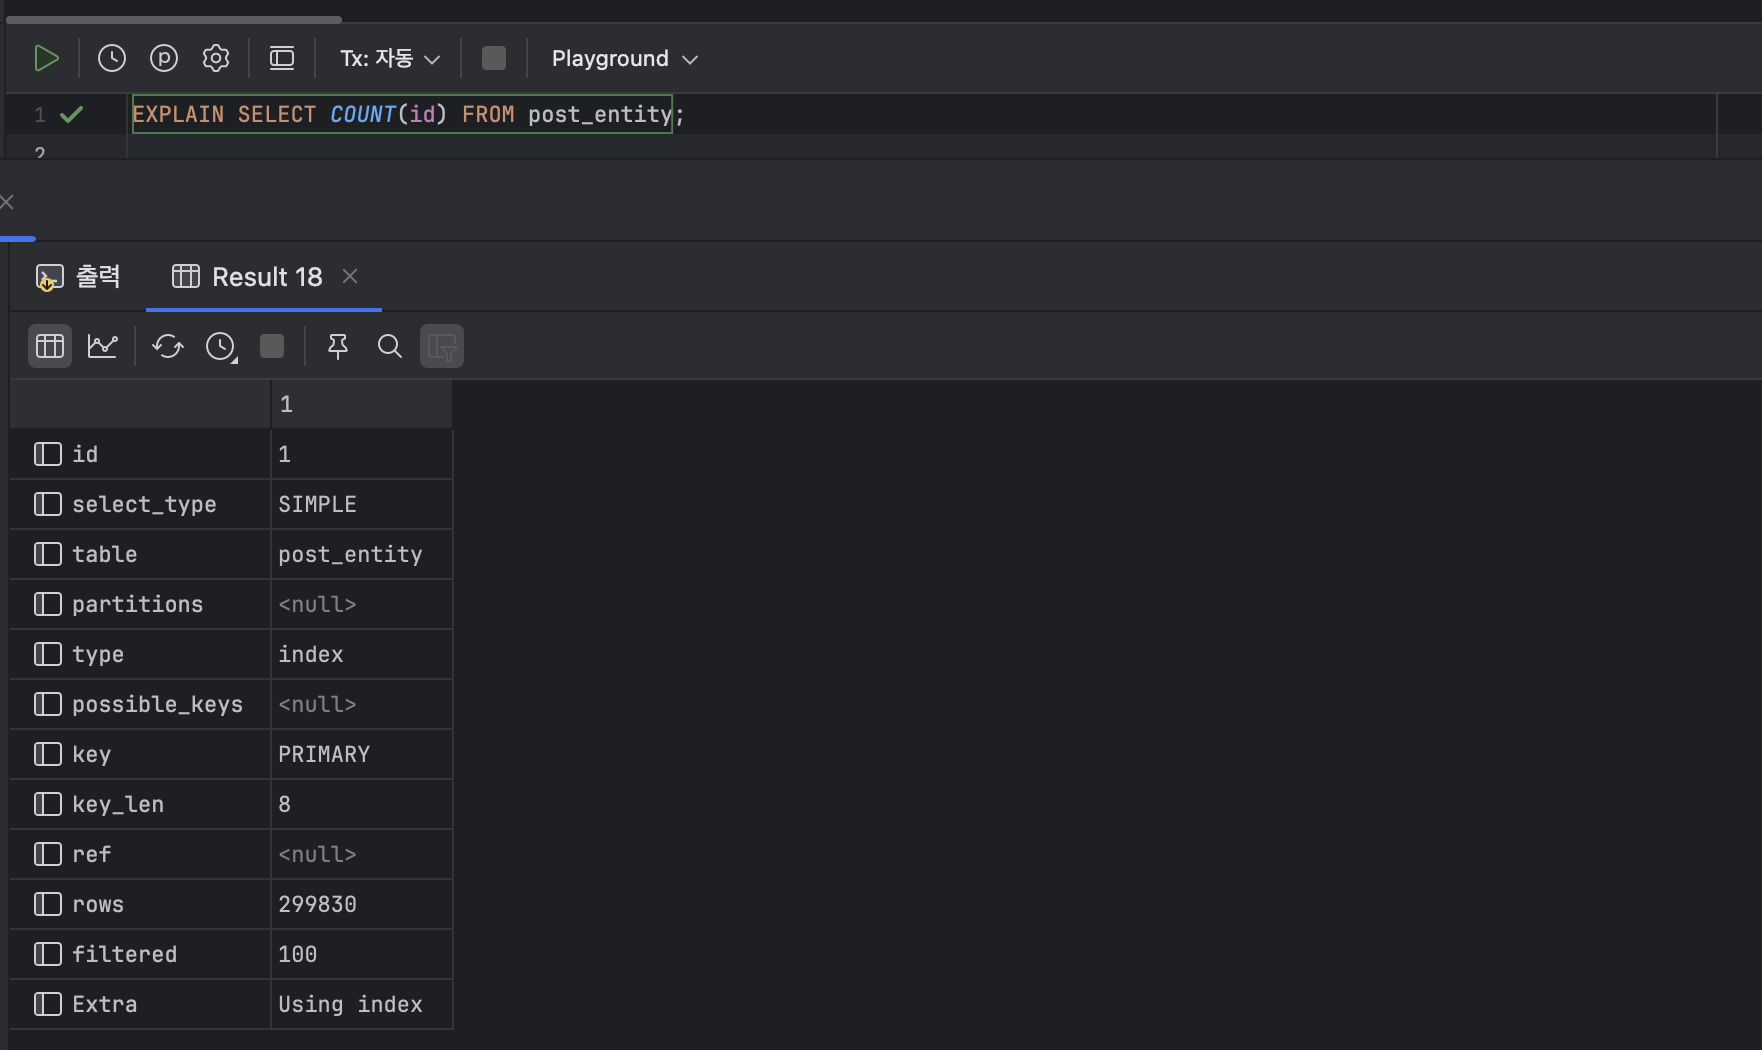
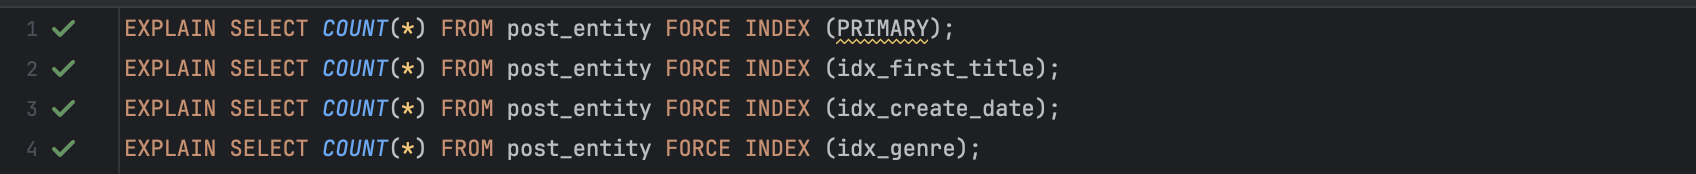
EXPLAIN SELECT COUNT(*) FROM post_entity;
type
possible_keys
key
key_len
Extra
index
NULL
PRIMARY
8
Using index
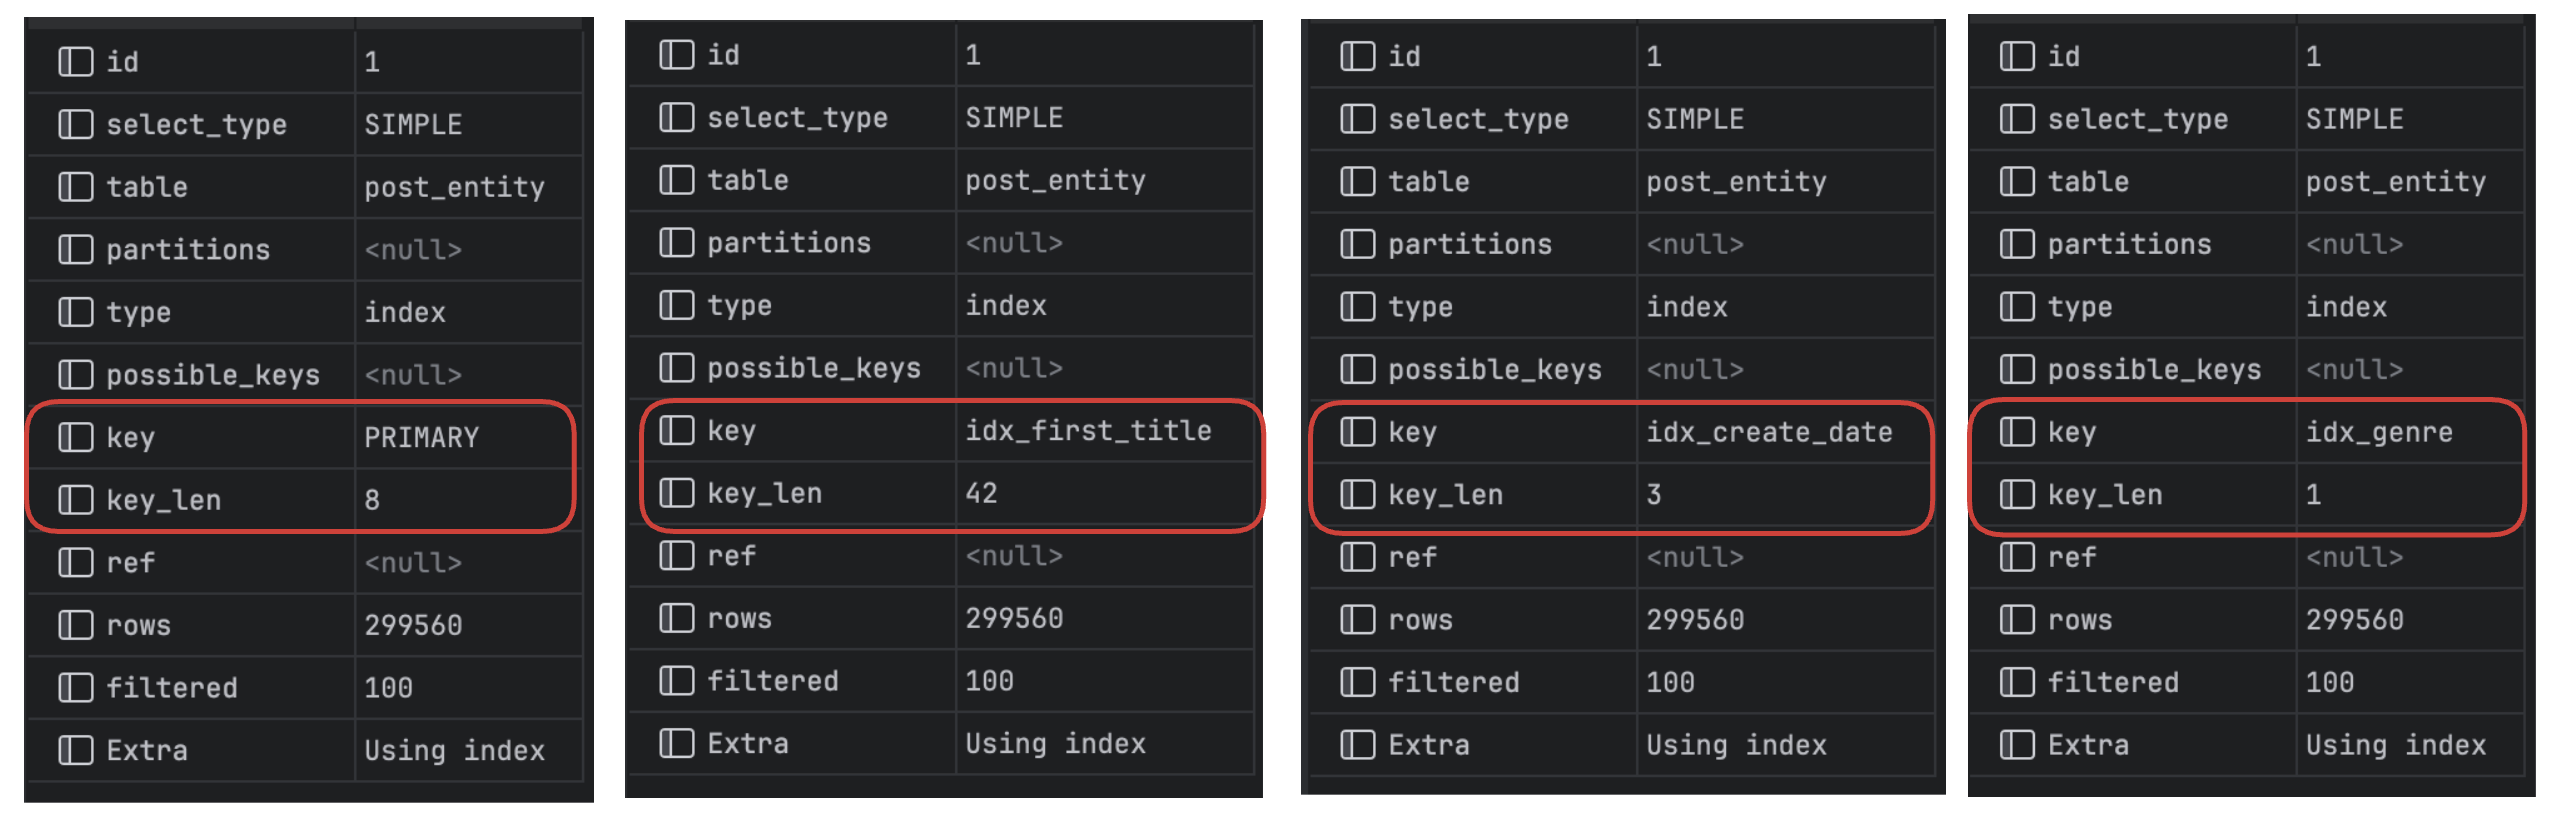
예상대로 PRIMARY가 선택됐다. key_len = 8은 id가 bigint 타입이기 때문이다. 그런데 인덱스를 추가하자 결과가 달라진다.
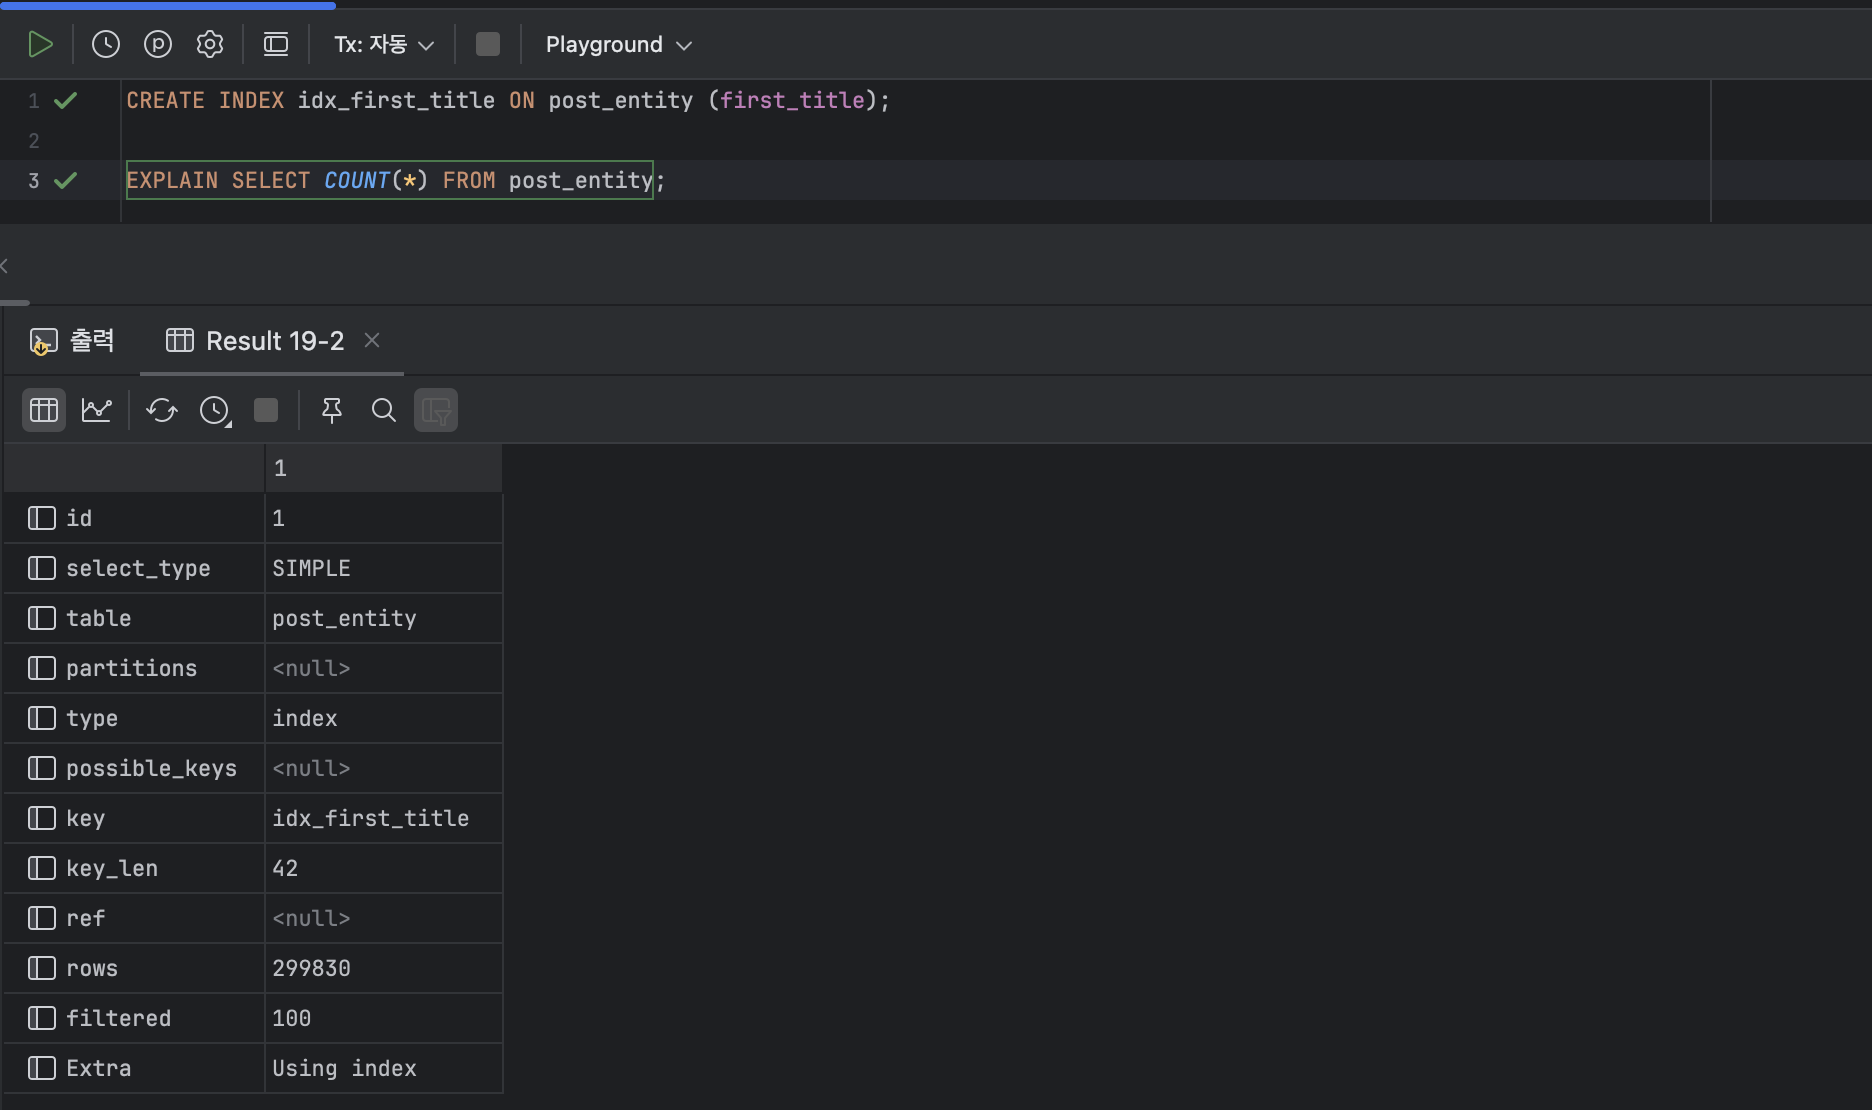
제목 컬럼에 인덱스를 추가했더니
CREATE INDEX idx_first_title ON post_entity (first_title);

EXPLAIN SELECT COUNT(*) FROM post_entity;
type
possible_keys
key
key_len
Extra
index
NULL
idx_first_title
8
Using index
COUNT(*)를 요청했는데 제목 인덱스를 사용한다. 쿼리를 바꾼 것이 아니라 인덱스만 추가했을 뿐인데 실행 계획이 달라졌다.
장르(enum) 인덱스를 추가했더니
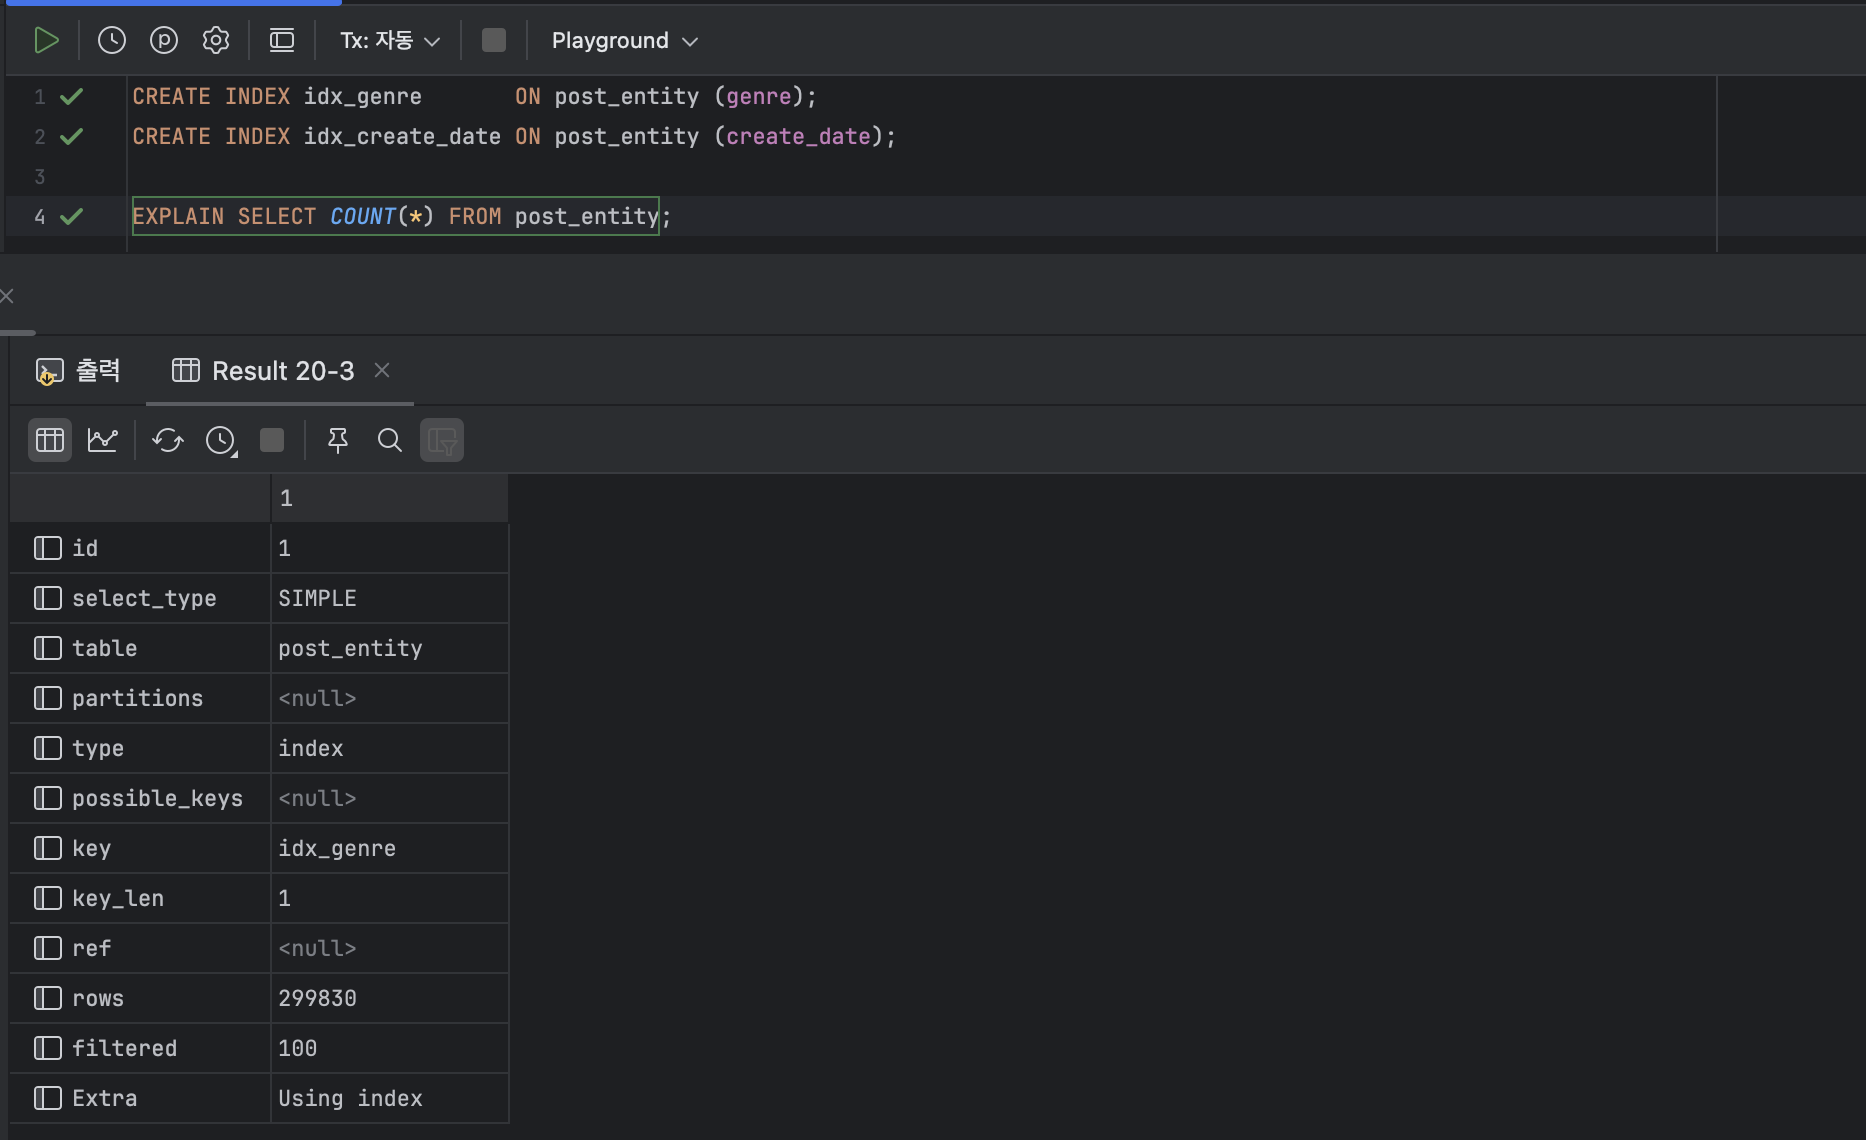
CREATE INDEX idx_genre       ON post_entity (genre);
CREATE INDEX idx_create_date ON post_entity (create_date);

EXPLAIN SELECT COUNT(*) FROM post_entity;
type
possible_keys
key
key_len
Extra
index
NULL
idx_genre
1
Using index
또다시 갈아탔다. enum 값이 3개뿐이라 크기는 1바이트, 지금까지 중 가장 작은 인덱스다.
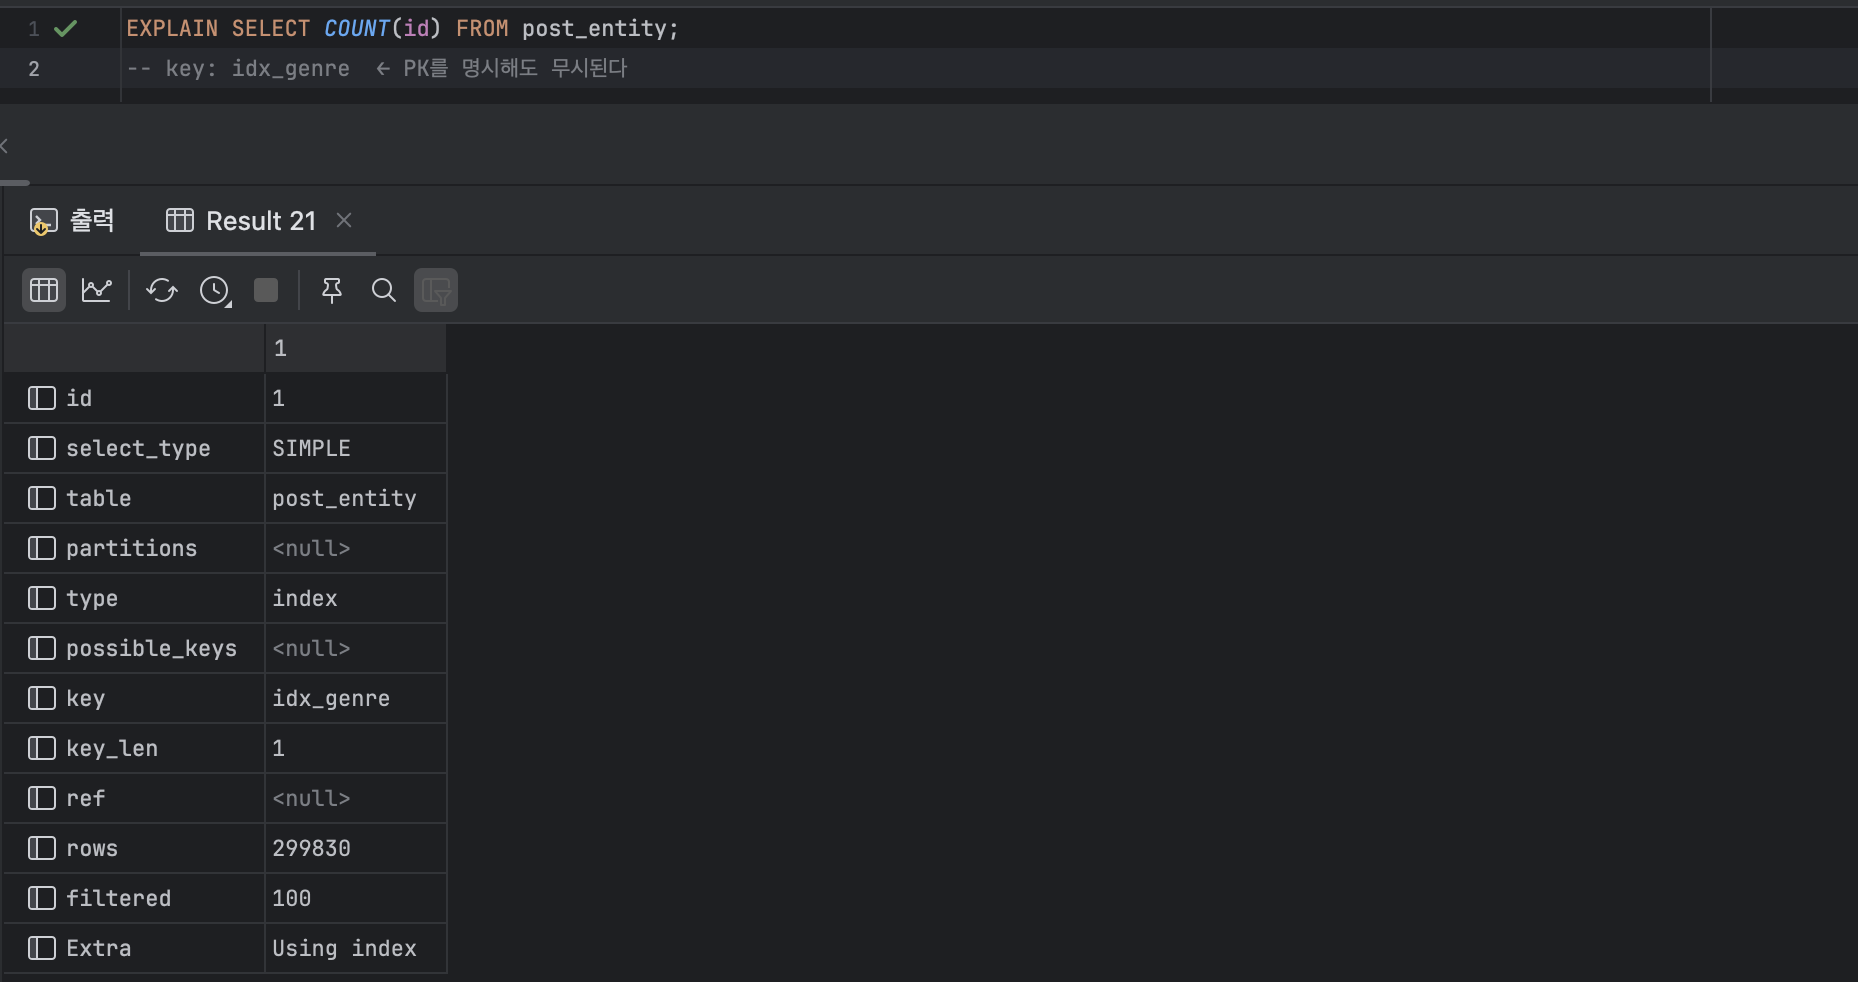
PK를 직접 지정해 봐도
COUNT(id)의 id는 "이 컬럼이 NULL이 아닌 개수를 세라"는 뜻이지 "이 인덱스를 사용하라"는 뜻이 아니다. 이 둘을 혼동하고 있었다.
인덱스 추가에 따라 key가 PRIMARY → idx_first_title → idx_genre로 바뀌는 EXPLAIN 결과들을 확인했다.
✅ Q2(가장 작은 세컨더리의 기준) 확인 완료 COUNT(*)는 PK가 아니라 가장 작은 세컨더리 인덱스를 훑는다. 세컨더리 인덱스가 없을 때만 클러스터 인덱스(PRIMARY)로 갔다. 뒤집어 말하면 작은 인덱스 하나만 있어도 COUNT가 빨라질 수 있다는 뜻이라, 개선 방향 하나를 여기서 얻었다.
다만 "작다"의 기준은 여전히 풀리지 않았다. 오히려 숫자가 이상하게 나왔다.
06 key_len과 "작다"의 기준
추가 질문 — key_len이 42인 인덱스가.. 8바이트 PK보다 작다는건가? 숫자가 맞지는 않는데
위 Q2는 "가장 작은 인덱스를 사용한다"로 답이 났다. 그런데 결과를 다시 보다 이상한 점을 발견했다. idx_first_title의 key_len은 42, PRIMARY는 8이다.
"가장 작은 인덱스를 사용한다"는 설명이 맞다면 8인 PK를 두고 42짜리로 갈아탄 것은 앞뒤가 맞지 않는다. 여기서 나는 key_len을 기준으로 작다를 판단하고 있었다. 하지만 결과는 그 판단과 반대다. 둘 중 하나다. key_len을 부족하게 알고 있거나, "작다"의 기준이 애초에 생각한 것과 다르거나.
key_len의 정의를 다시 확인
MySQL 공식 문서 · EXPLAIN Output Format — The key_len column indicates the length of the key that MySQL decided to use. The value of key_len enables you to determine how many parts of a multiple-part key MySQL actually uses.
다시 읽어보니 이 정의 어디에도 "인덱스의 크기"라는 말이 없다. "length of the key that MySQL decided to use" - 실행계획이 실제로 사용한 키 컬럼의 바이트 길이 합을 알려주는 숫자다. 나는 "작다 = key_len이 작다"로 읽었지만, 문서는 그런 말을 한 적이 없고 오해석을 했다..
그럼 옵티마이저는 뭘 보고 "작다"를 판단하는 걸까? 옵티마이저가 판단 기준으로 삼는 "크기"는 따로 있다는 뜻이 된다. 가능성을 두 개로 좁혔다.
A 가설
물리적 크기 — 인덱스가 실제로 차지하는 페이지 수 디스크에서 읽을 페이지가 적을수록 싸다는 것은 직관적이다. 클러스터 인덱스는 리프에 row 전체를 담으니 페이지가 많을 테고, 그래서 밀렸을 수 있다.
B 가설
key_len이 맞는데, 후보 집합을 잘못 보고 있었다 애초에 클러스터 인덱스는 후보에 들어가지 않는 것이라면? 그러면 "세컨더리 중 key_len 최소"가 되고, PRIMARY와 비교할 일 자체가 없어진다.
물리적 크기 측정
InnoDB 통계 관련 문서를 뒤지다가 옵티마이저 전용으로 유지되는 통계 테이블을 하나 발견했다. mysql.innodb_index_stats인데, stat_name = 'size'인 행의 stat_description이 "Number of pages in the index"로 되어 있다. 인덱스의 "크기"라는 통계가 페이지 수로 정의되어 있는 것이다.
권한 주의 - mysql.innodb_index_stats는 애플리케이션 계정으로는 조회할 수 없다. SELECT command denied to user ... for table 'innodb_index_stats' 가 뜨면 root로 접속하거나 아래처럼 읽기 권한만 부여하면 된다.
GRANT SELECT ON mysql.innodb_index_stats TO 'learn'@'%';
GRANT SELECT ON mysql.innodb_table_stats TO 'learn'@'%';
FLUSH PRIVILEGES;
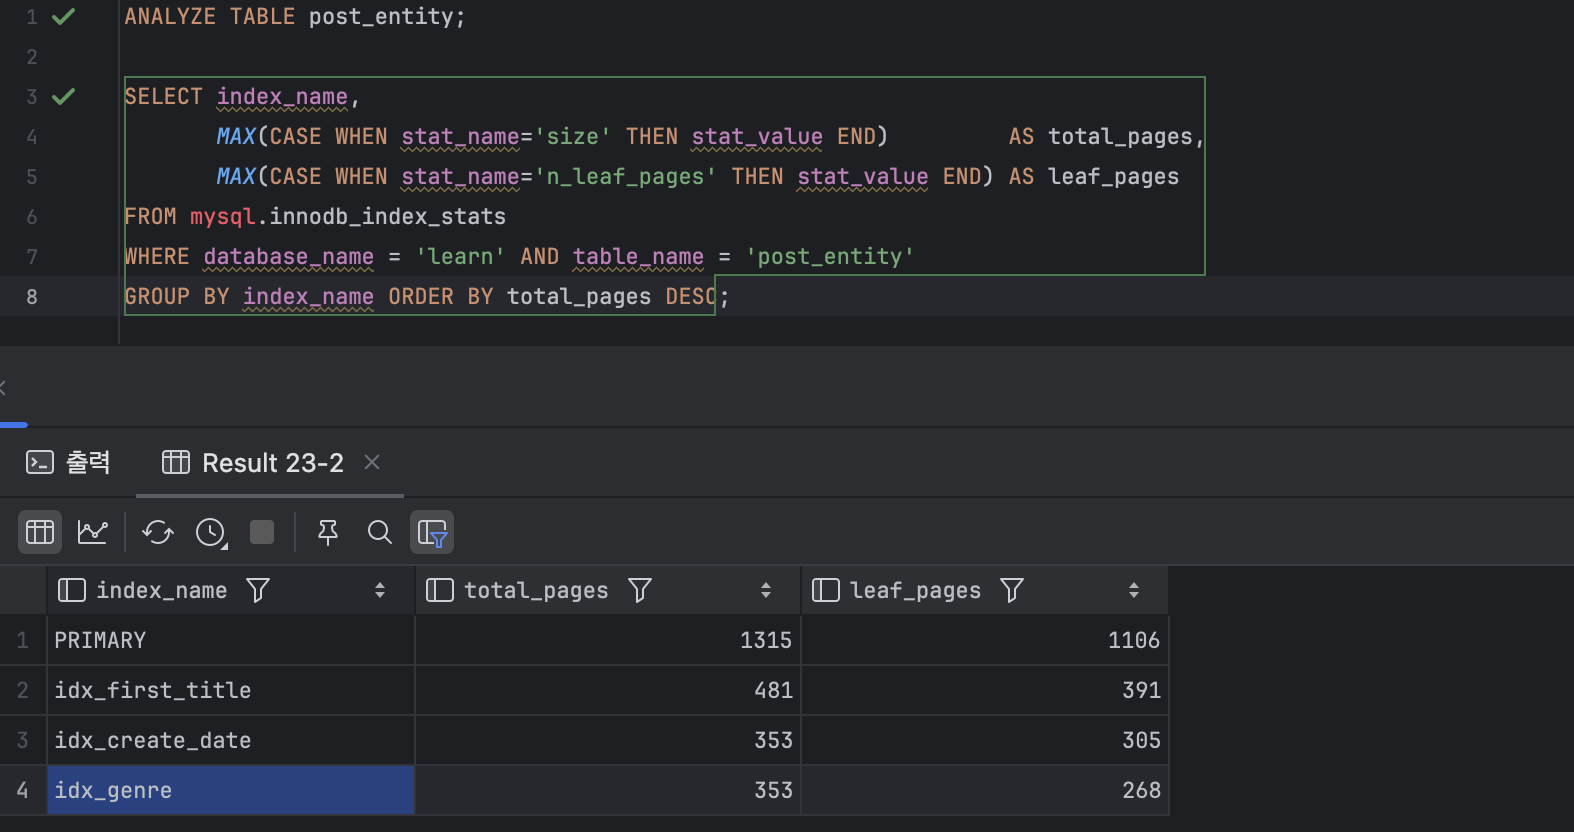
query - 인덱스별 실제 페이지 수
이 쿼리가 돌려주는 것은 페이지 수뿐이다. 비교하려면 인덱스별 key_len이 함께 있어야 하는데, 그 값은 통계 테이블이 아니라 실행계획에서 나온다.FORCE INDEX로 인덱스를 하나씩 강제하면 각각의 key_len을 볼 수 있다.
두 결과를 나란히 놓으면 다음과 같다.
total_pages · leaf_pages는 innodb_index_stats / key_len은 EXPLAIN에서 가져온 값이다
인덱스
total_pages
leaf_pages
key_len
선택
PRIMARY
1,315
1,106
8
idx_first_title
481
391
42
idx_create_date
353
305
3
idx_genre
353
268
1
✅
크기 순서가 옵티마이저가 갈아탄 순서와 모순되지 않는다. PRIMARY가 제일 크고, 그다음이 idx_first_title이다. 가설 A가 맞는 것처럼 보였다.
두 숫자의 차이 - size는 세그먼트에 할당된 페이지까지 포함하므로 테이블을 재구축하면 값이 조금씩 달라진다. 실제로 스캔하는 양에 가까운 것은 n_leaf_pages다. 아래 비교에서는 size를 쓰되, 절대값보다 인덱스 간의 순서를 본다.
그런데 걸리는 것이 하나 있다. idx_genre와 idx_create_date는 페이지 수가 353으로 동일하다. 그런데 옵티마이저는 idx_genre를 골랐다. 페이지 수가 기준이라면 이 선택을 설명할 수 없다. 반면 key_len으로는 설명이 된다(1 < 3) 좀 더 세부 비교가 필요한것 같다.
두 기준을 확인하기 위한 판별 실험
문제는 보통 두 기준이 같은 답을 낸다는 것이다. key_len이 작으면 엔트리도 작고, 엔트리가 작으면 페이지도 적어지기 때문이다. 실제로 앞의 네 인덱스는 동률을 빼면 두 기준의 순위가 같았다.
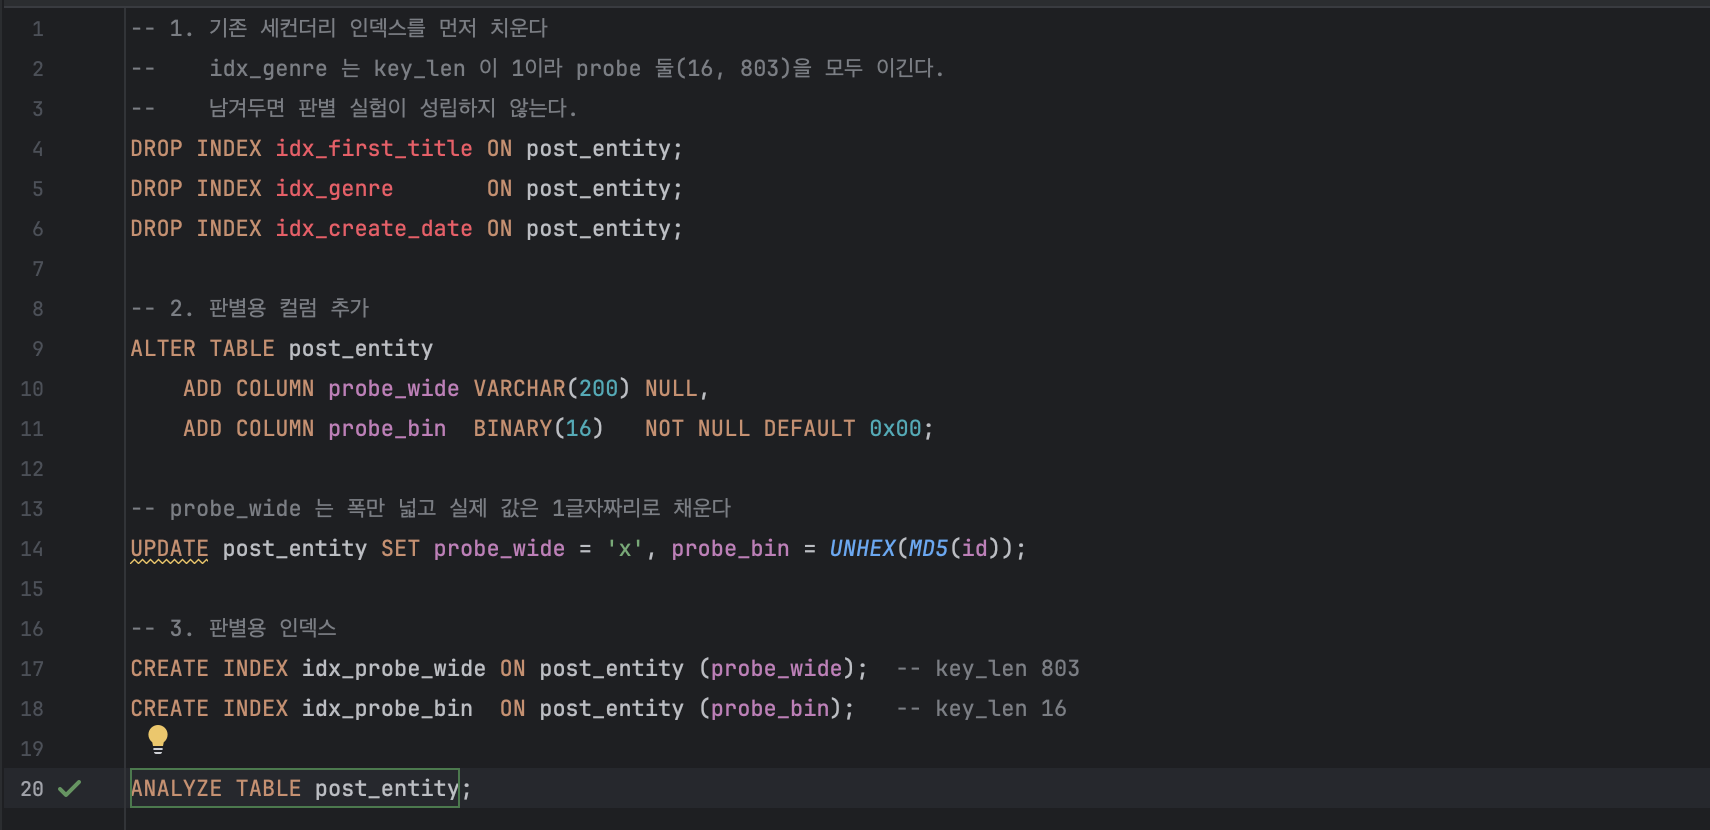
그래서 일부러 두 기준이 반대로 가는 인덱스 두 개를 만들었다.
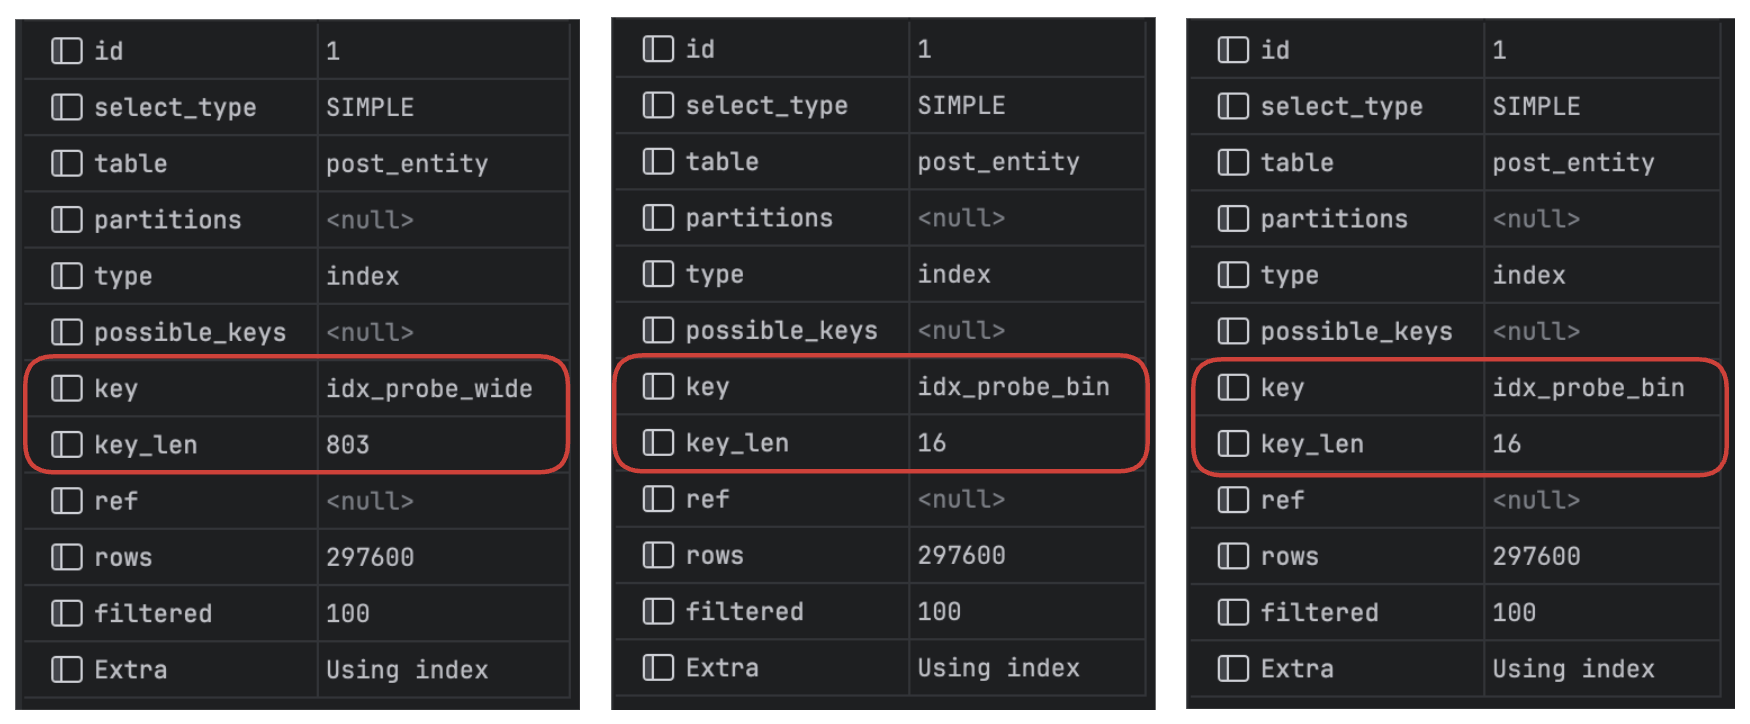
probe_wide는 varchar(200)이라 key_len은 803으로 아주 큰데, 실제로는 'x' 한 글자만 들어 있어서 엔트리가 작고 페이지도 적다. probe_bin은 반대로 key_len이 16으로 작지만 16바이트를 꽉 채워서 페이지가 많다.
인덱스
total_pages
key_len
가설 A 예측
가설 B 예측
idx_probe_wide varchar(200),값은 1글자
353 작음
803 큼
이걸 고른다.
idx_probe_bin binary(16)
675 큼
16 작음
이걸 고른다.
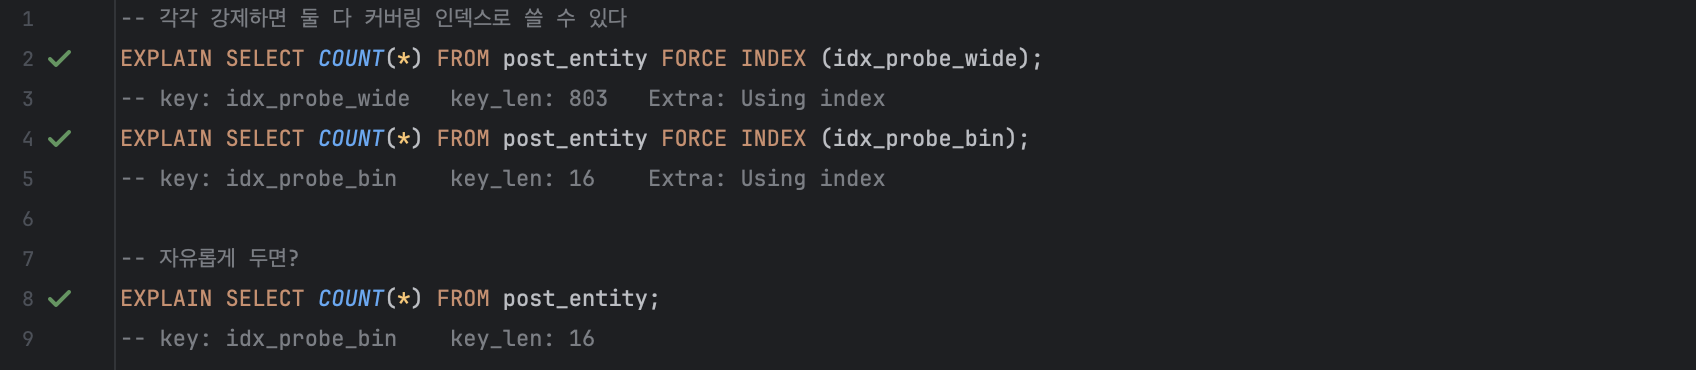
두 기준이 정반대를 가리키도록 설계했고, 어느 쪽을 고르는지만 보면 된다
페이지가 약 2배 많은 쪽을 골랐다.
idx_probe_wide353페이지짜리를 두고 idx_probe_bin675페이지짜리를 선택했다.
가설 A는 여기서 탈락이다.
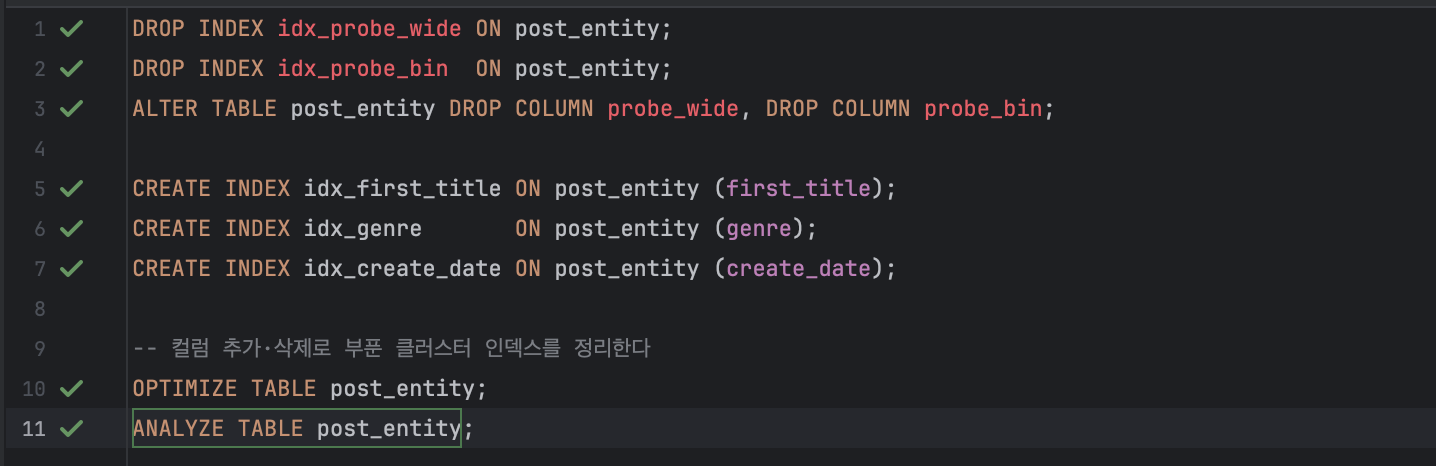
옵티마이저는 물리적 페이지 수를 기준으로 고르는 것이 아니었다. 다음은 실험을 원복.
실험 후 원복
클러스터 인덱스의 취급
가설 B가 남았다. "세컨더리 중 key_len 최소"라면 PRIMARY는 애초에 후보가 아니어야 한다. 확인해봤다.
후보
key_len
선택
PRIMARY vs idx_probe_bin
8 vs 16
idx_probe_bin - key_len이 더 큰 쪽
세컨더리를 모두 제거
8
PRIMARY - 다른 선택지가 없으므로
순수하게 key_len만 비교했다면 PRIMARY(8)가 이겼어야 하는데 그렇지 않았다. 그리고 세컨더리를 전부 없애자 그제서야 PRIMARY로 갔다. 클러스터 인덱스는 세컨더리가 하나라도 있으면 후보에서 빠지는 것이다.
근거
이 동작의 출처가 MySQL 버그 트래커에 있다.
참고 MySQL Bug #39653 함수 이름이 find_shortest_key, 즉 "가장 짧은 키를 찾는다"이다. 기준이 애초에 키 길이였다는 것이 이름에 그대로 드러나 있다..^^
제목 그대로 find_shortest_key라는 함수가 원래는 키 길이만 보고 골랐고, 클러스터드 PK를 고려하지 않는 것이 버그로 보고됐다는 내용이다.
리포트의 재현 예시가 내 상황과 같다. PRIMARY(a)와 KEY(b,c)가 있는 InnoDB 테이블에서 COUNT(*)를 하면 key_len이 작다는 이유로 PRIMARY를 골랐는데, 클러스터드 PK 스캔은 전체 행 데이터를 읽는다는 사실이 반영되지 않았다는 것이다. 이 수정이 5.1.46 · 5.5.5부터 반영됐다.
정리된 규칙
📌 세컨더리 인덱스 중 key_len이 가장 작은 것을 고른다. 📌세컨더리가 하나도 없을 때만 클러스터 인덱스(PRIMARY)를 스캔한다.
상황
세컨더리 후보 (key_len)
선택
설명
세컨더리 없음
-
PRIMARY
후보가 없으므로 클러스터 인덱스
+ idx_first_title
42
idx_first_title
유일한 세컨더리 · PK(8)와는 비교하지 않음
+ idx_genre, idx_create_date
42/1/3
idx_genre
세컨더리 중 최소
idx_genre 제거
42 / 3
idx_create_date
세컨더리 중 최소
07 WHERE 조건이 COUNT 최적화 경로에 미치는 영향
Q3 · 문서 4- WHERE가 붙으면 얼마나 느려지는가. 인덱스로 만회할 수는 없는가
Q2와 06장에서 "세컨더리 인덱스를 하나 걸어두면 COUNT가 그쪽으로 간다"는 것이 확인됐다. 그렇다면 01장에서 인덱스를 추가했을 때 효과가 있었어야 하는데 없었다. 둘 중 하나가 틀렸다는 뜻이다.
실험과 실제 API를 나란히 놓고 무엇이 다른지 찾아봤다. 데이터 크기, 테이블 구조, MySQL 버전은 대부분 비슷했는데 한 가지가 눈에 들어왔다.
-- 05·06장에서 관찰한 것
SELECT count(*) FROM post_entity;

-- 01장에서 실제로 느렸던 것
SELECT count(*) FROM exhibitions WHERE ...   ← 조건이 붙어 있다
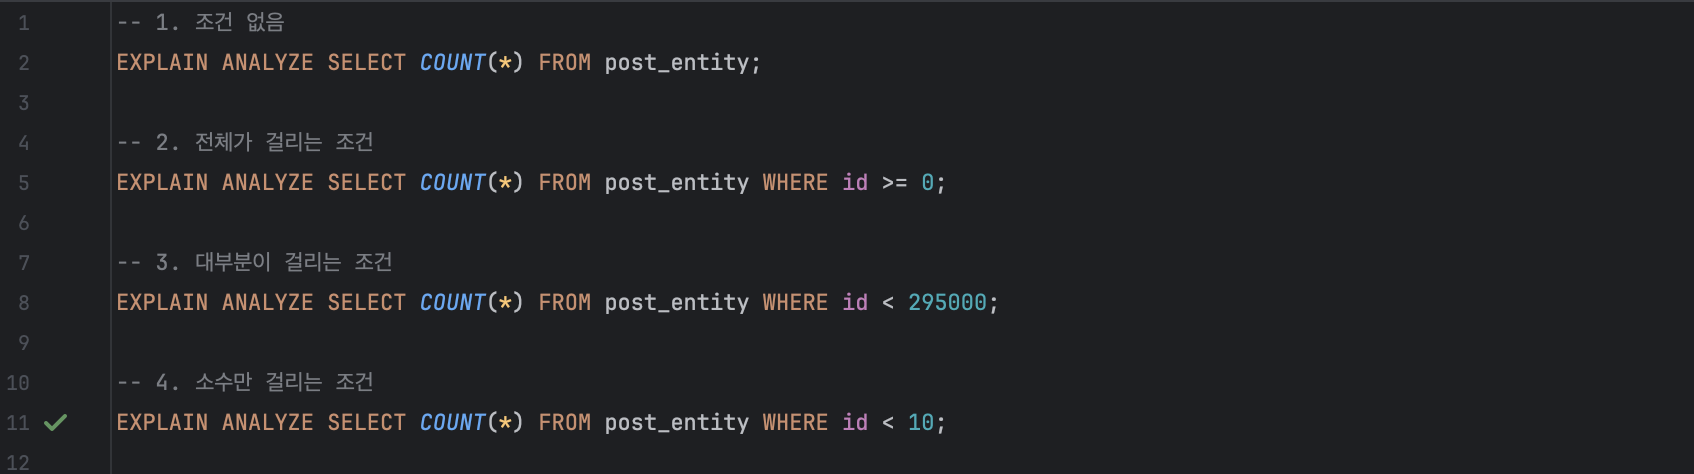
실험 내내 측정하고 있던 것은 조건 없는 COUNT(*)였다. 목록 API의 count에는 거의 항상 필터가 붙는데도 그랬다. WHERE 하나 붙는 것이 그렇게 큰 차이일까. 세는 행 수가 같다면 별 차이가 없어야 한다고 생각했다. 조건별로 나눠서 측정했다.
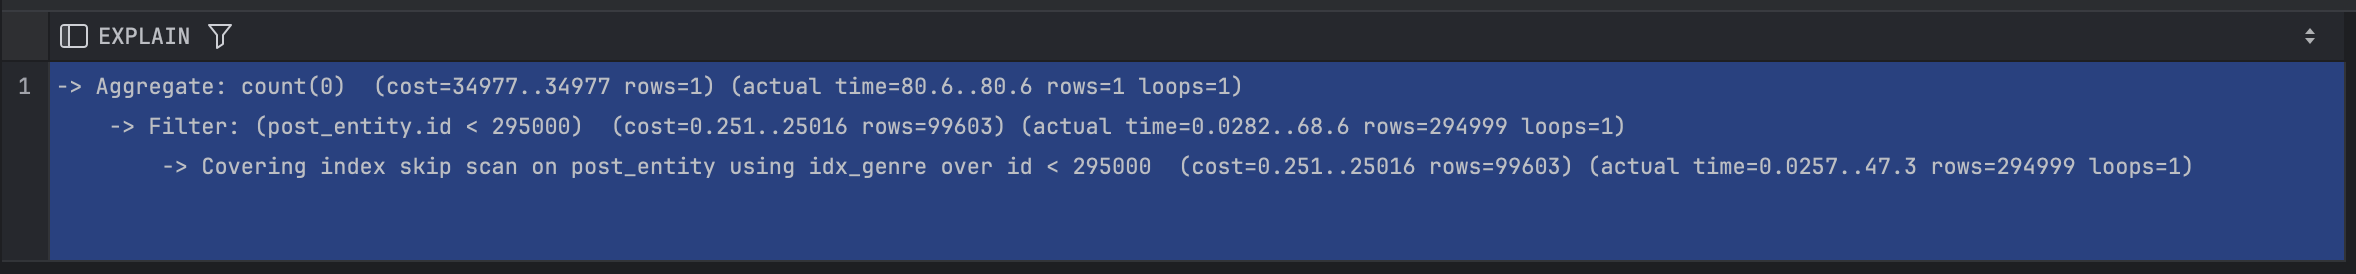
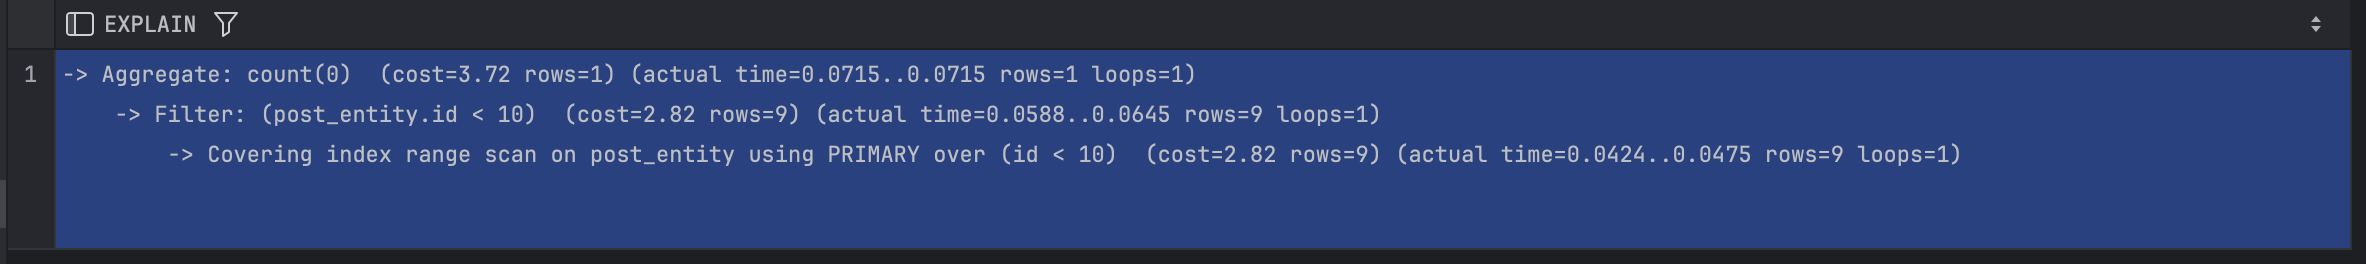
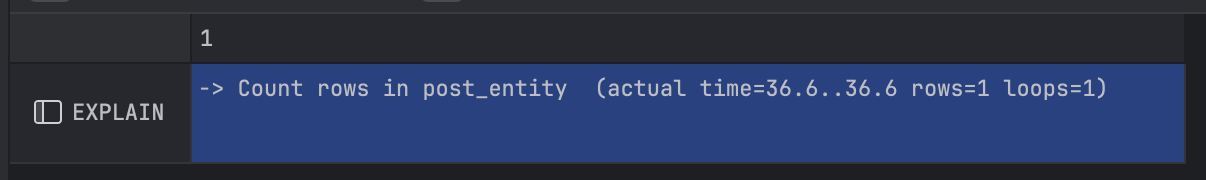
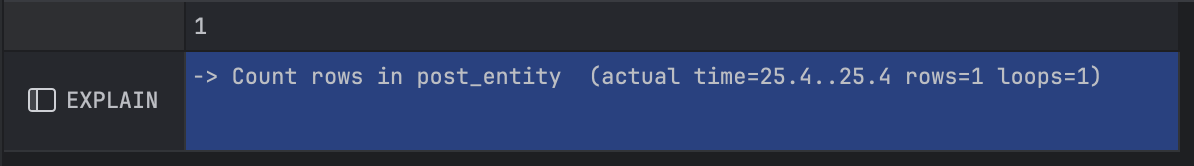
조건별 측정 (각각 3회 실행) post_entity · 300,000행
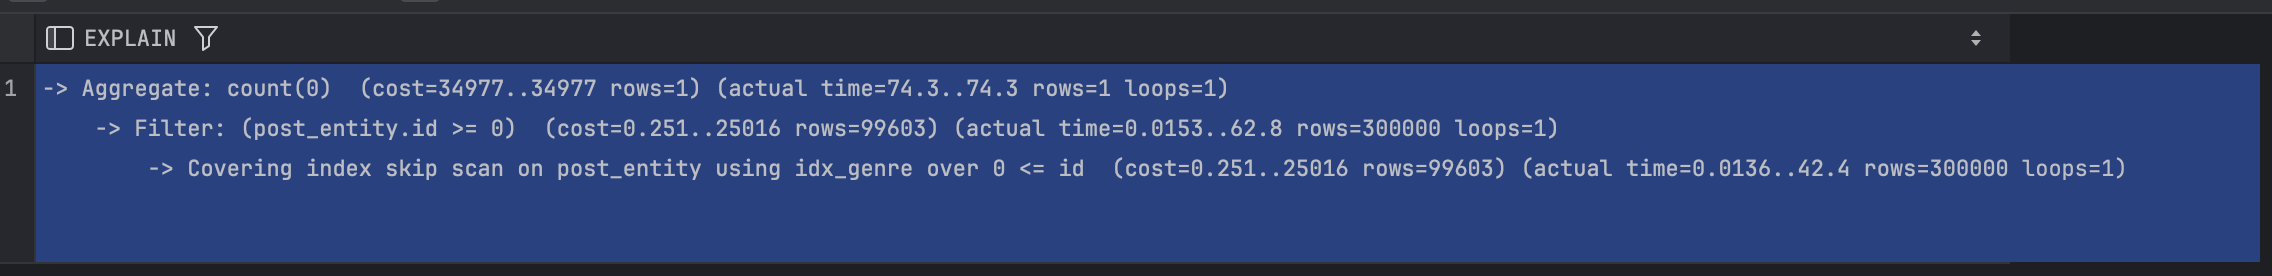
EXPLAIN ANALYZE 읽는 법 결과는 안에서 밖으로 실행된다. 각 줄 actual time=a..b 에서 b가 그 단계까지의 누적 시간이다. Filter 줄의 rows= 는 조건을 통과한 행 수이므로, 2번에서 rows=300000 이면 결국 전부 통과했다는 뜻이다.
#
조건
실행 계획
acutal time
1
없음
Count rows in
26ms
2
id >= 0 (전체가 걸림)
Aggregate + Filter + skip scan (idx_genre)
74ms
3
id < 295000 (대부분)
동일
80ms
4
id < 10 (소수)
Aggregate + Filter + range scan (PRIMARY)
0.07ms
1번과 2번은 결국 똑같이 300,000행을 센다. 그런데 1번이 빠르다. 실행 계획을 보면 1번만 Count rows in이라는 다른 경로를 탄다.
2·3번이skip scan인 것은 idx_genre 때문이다. 세컨더리 인덱스에는 PK가 따라붙으므로 idx_genre는 사실상 (genre, id)가 되고, 옵티마이저는 genre 값 3개를 건너뛰며 각 그룹 안에서 id 범위를 훑는다. 4번만 PRIMARY range scan인데, 걸리는 행이 9개뿐이라 PK로 바로 좁히는 쪽이 싸기 때문이다. 어느 쪽이든 Filter와 Aggregate가 붙는다는 점은 같다.
혹시 1번은 어딘가에서 값을 읽어오는 것이 아닐까 싶었는데, 4번이 그 추측을 깬다. 값을 읽어오는 것이라면 9행만 세는 4번보다 빨라야 하는데 그렇지 않다. Q1에서 확인한 대로 1번도 실제로 스캔하고 있다. 다만 더 싼 방법을 쓸 뿐이다.
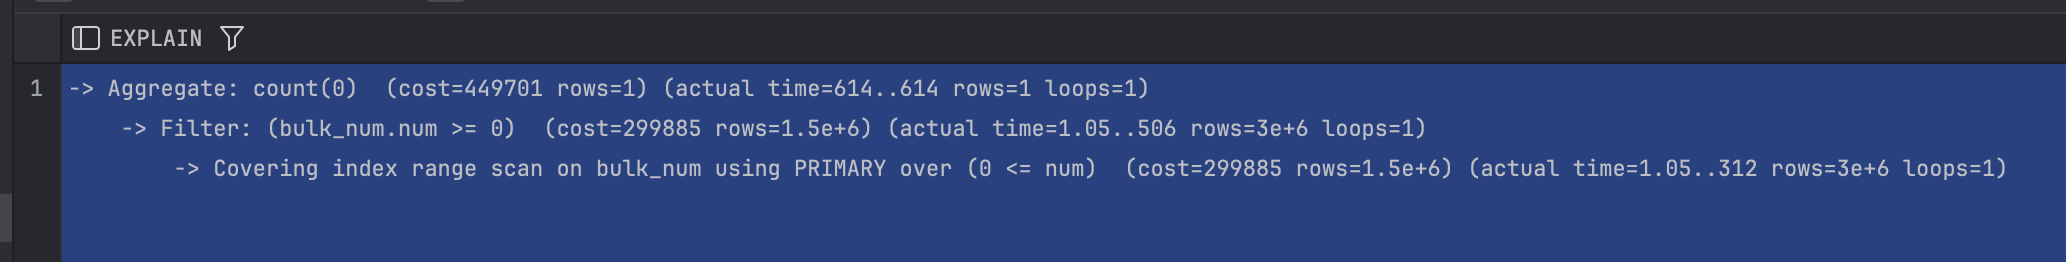
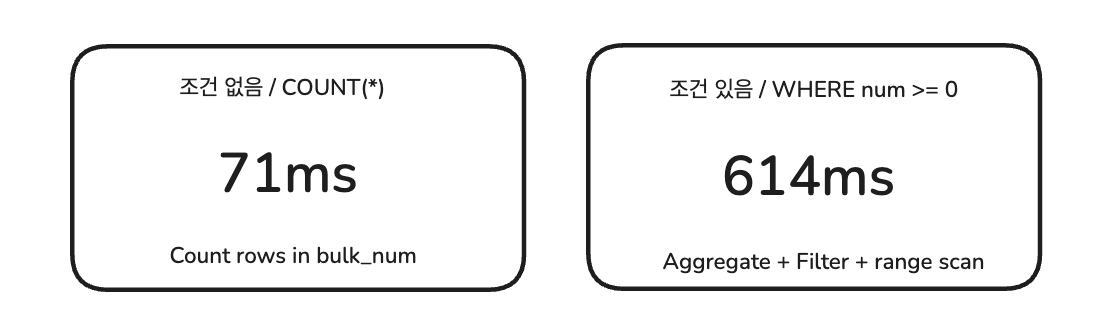
격차를 키운 대조군 실험
Explain
세는 행 수는 똑같이 300만인데 8배 차이가 난다. 시간이 어디서 쌓이는지 확인해보자.
-> Aggregate: count(0) (actual time=614...614 rows=1 loops=1) -> Filter: (bulk_num.num >= 0) (actual time=1.05..506 rows=3e+6 loops=1) -> Covering index range scan on bulk_num using PRIMARY over (0 <= num) (actual time=1.05..312 rows=3e+6 loops=1)
index range scan
312ms - 인덱스를 훑는 데까지
+ Filter
506ms - 조건 통과 여부를 판정하며 +194ms
+ Aggregate
614ms - 집계하며 +108ms
스캔 자체보다 필터·집계 단계에서 붙는 비용이 크다. 조건 없는 쿼리는 이 두 단계가 통째로 생략되고 Count rows in 로 끝난다.
02장에서 읽은 문서 4가 바로 이 이야기였다. "WHERE나 GROUP BY 같은 추가 절이 없는 경우에 한해 최적화되어 있다"는 문장이다. 그때는 조건절이 붙는지 여부가 이 정도 차이를 만들 거라고 생각하지 못했는데, Count rows in과 Aggregate + Filter는 아예 다른 실행 경로였다.
08 COUNT(expr)과 NULL 허용 여부
개선안을 검토하다 COUNT(*) 대신 특정 컬럼을 세는 방식을 떠올렸는데, 실행하지 않길 잘했다.
문서 3과 Q2에서 "옵티마이저가 가장 작은 인덱스를 알아서 고른다"는 것을 확인했다. 거기에 문서 1의 COUNT(expr) 문법을 겹쳐 보니 이런 생각이 들었다. "알아서 고르게 두지 말고, 아예 COUNT(genre)처럼 작은 컬럼을 직접 지정하면 확실하게 빨라지지 않을까."
03장에서 테이블을 만들 때 비교할 수 있도록 NULL도 미리 섞어둔 상태였다. 기대는 "조금 더 빨라지거나, 최소한 같겠지"였는데 결과는 정반대였다.
그리고 여기서 나온 결과는 02장에서 읽은 네 문장 어디에도 없는 내용이었다. 문서가 말하지 않은 영역이라 더 짚어둘 만하다.
인덱스 없는 nullable 컬럼을 세면
type
possible_keys
key
key_len
ALL
NULL
NULL
NULL
type = ALL 풀 테이블 스캔이다. 인덱스를 세 개나 걸어둔 테이블인데 하나도 쓰지 못한다. second_title은 nullable이면서 인덱스가 없으니, NULL인지 확인하려면 실제 row를 전부 읽어야 하기 때문이다.
그렇다면 NOT NULL인 first_title은 어떨까.
EXPLAIN
실행 계획이 똑같다. NOT NULL이니까 MySQL이 "이 컬럼은 절대 NULL일 수 없다 → 결국 전체 행 수와 같다"고 판단해서 COUNT(*)로 치환해버린 것이다. 컬럼을 지정해봐야 이득이 없다는 뜻이다.
대상
실행 계획
읽어야 하는 것
COUNT(*)
Count rows in
가장 작은 인덱스
COUNT(NOT NULL 컬럼)
Count rows in
동일 (치환됨)
COUNT(인덱스 있는 nullable)
index scan
해당 인덱스
COUNT(인덱스 없는 nullable)
ALL (풀 스캔)
테이블 전체
문서에 없던 내용 02장의 네 문장은 COUNT(*)가 어떻게 처리되는지는 알려주지만, COUNT(expr)를 썼을 때 인덱스를 못 쓰게 된다는 이야기는 하지 않는다. NOT NULL이면 COUNT(*)로 치환된다는 것도 마찬가지다.
그래서 조심할 부분
COUNT(deleted_at), COUNT(email)처럼 nullable 컬럼을 무심코 세면 인덱스가 아무리 많아도 풀 스캔이 나간다. "NULL이 아닌 것만 세고 싶다"는 의도라면 COUNT(*) WHERE col IS NOT NULL과 해당 컬럼 인덱스를 함께 검토하는 편이 낫다.
정리 - 실험으로 확인한 COUNT의 규칙
#
규칙
챕터
1
InnoDB는 행 수를 저장하지 않는다. MVCC 때문에 저장할 수가 없고, COUNT는 매번 현재 트랜잭션에 보이는 행을 실제로 센다.
03
2
조건 없는 COUNT(*)는세컨더리 인덱스 중 key_len이 가장 작은 것을 훑는다. 물리적 페이지 수 기준이 아니다.